强化学习--DQN
什么是 DQN?
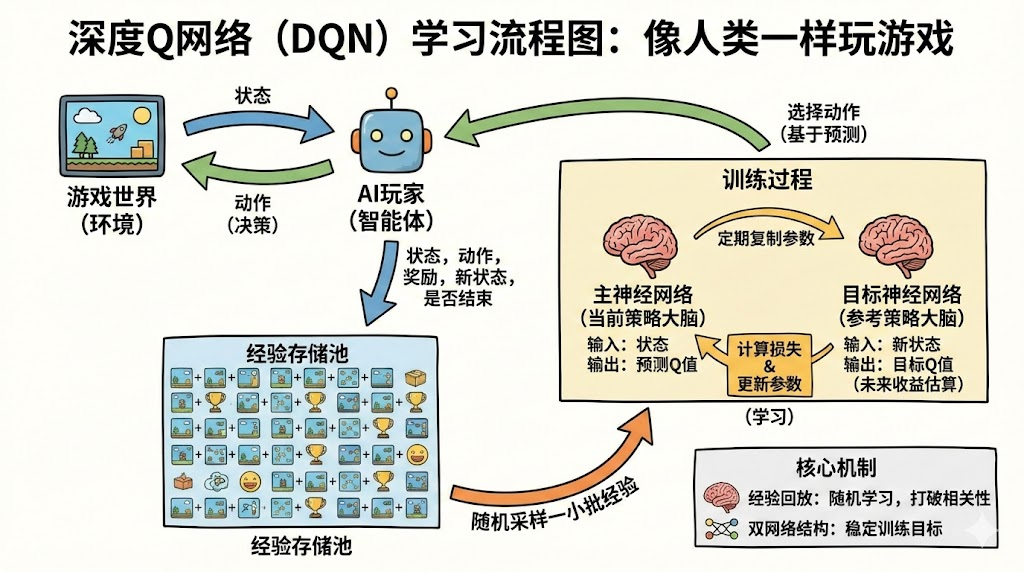
DQN 流程图
本质上 DQN 仍然是一个 Q 网络,只不过由原来的 Q 表转换为了神经网络,但他的目标依然还是最大化动作价值函数,
下棋根据 S 来决定下一步,需要策略,然后需要通过数学计算计算下一步最有利,就是 Q 函数。
监督学习的样本一般都是 ID,也就是独立同分布,强化学习的样本是时序相关,不满足独立性,更加难以收敛
为了解决这个问题,就引入两个思想,一个是经验回放,通过反复回顾和随机混合过去的经验,消除观测序列的相关性,其次就是不断调整动作价值 Q,Q 值趋近于目标价值,但是目标价值只是定期更新,而不是每一步都更新,是周期性的,这样能减少目标值之间相关性,从而提高学习效果。
折扣因子的作用,比如给你一块糖吃,但是需要延时奖励,我想最大化提前这个奖励时间,是给定一个缩放因子来实现。
经验回放把按时间顺序来的数据打散成一个大池子,每次随机抽一个 batch 来训练,一方面减弱时序相关性、更接近“样本近似独立”的假设,另一方面同一条经验可以多次被采样复用,更容易从中真正学到规律。
当然也有局限性
1.上下文有限,没有长期记忆,可以用 RNN,LSTM 来进行改进
2.经验存放的经验池物理空间有限,需要更新经验时无法区分哪些经验更有效。后续也有研究者改进了优先级经验重放,以及更新区分和保留有价值的经验,这样更频繁的进行学习和采样
不同类别的经验区分不同的类别和层次,这样更好的管理经验
QA 问答!
经验回放(Replay Buffer)
Q1:为什么一定要用经验回放,不能来一条经验就立刻训练一次?
可以一条一条的训练,只不过一般一个 batch 训一次,因为这就像有监督训练中的训练过程,单条数据,数据与数据之间过于离散,模型无法很好学习到规律,而一个 batch 就代表一个小批量的数据,这样能学到数据间的关联性
同时,单条训这样数据时序相关性过高,会导致训练梯度过抖,模型效果不稳定,经验回放可以复用同一份数据训练多次,增强稳定性,而单条只训一次,不一定能学到知识。
Q2:经验回放池容量太小 / 太大,各自会有什么问题?合适的容量应该满足什么直觉?
容量太小,就比如开车只存储了 10s 的操作,这样太片面,模型容易学歪,对最近的偶然情况过拟合。
容量太大,既有太老的又有最新的,如果随机拿出来训,会导致混乱,模型可能为了过度拟合之前存储的老数据(‘过时经验’),而导致对现策略值收敛过慢。
合适的容量应该是定期更新的,具有独立同分布性质的,这样有价值的经验模型能很好的学到东西。
衍生:独立同分布是啥?
简单理解就是一份数据,比如说一组猫,狗的照片,如果按住镜头抓拍,“知道上一帧长啥样”,就几乎能猜到下一帧长啥样,这就明显不独立了,这样会导致数据高度相关近似=1,同分布是啥?训练预测应该对齐,不能训练喂猫狗,预测来鳄鱼,就算训练是白天的猫狗照片,预测拿来夜晚拍的预测,也属于分布偏移,不属于同分布。
Q3:经验回放会不会让“最新的数据”利用不足?为什么说这是一个“稳定性 vs 即时性”的权衡?
当前是随机性的筛选出数据拿来训练,也并不是只训练一次,可能同一份数据会训多次。
因为最新数据并不会直接进行训练,而是先存入经验池,随机进行训练,会有一点没利用到的问题,但这样会带来一个好处,训练时混合了新旧经验的 batch,这样做的好处就是模型不会被少量极端性数据带偏,而是新数据本身会不断进入经验池,并且在“滚动窗口”里反复被采样,长期来看,会对训练拟合策略有更好的帮助。
Q4:ε-greedy 已经让动作有随机性了,为什么还需要经验回放?这两个东西各自解决什么问题?
二者解决的问题不同,ε-greedy 解决的是选择哪个动作的问题,而经验回放解决的是模型学习哪些东西的问题。也就是 选择哪些经验进入经验回放池,而经验回放池通过打乱、批量采样的方式来提高学习的稳定性和效率。
目标网络(Target Network)
Q5:在线网络和目标网络结构几乎一样,为什么还要分成两个?不直接用一个网络会有什么问题?
如果只有一个网络,它既用来算当前 Q 值,又用来算未来的目标 Q 值,那每次更新都会同时改变“自己”和“目标”,学习目标一直在乱动,很容易震荡甚至崩。
把它拆成在线网络和目标网络以后,在线网络负责不停学习,目标网络在一段时间内冻结,只提供相对稳定的参考。在线网络始终在追一个暂时固定的目标,稳定一阵之后,再把它的参数整体复制到目标网络,让目标“分阶段地”更新。
Q6:目标网络一开始的参数是怎么设定的?和在线网络的关系是什么?
一开始,目标网络的参数就是在线网络参数的完整拷贝,两者结构和数值都一样。
在训练中,目标网络始终扮演“参考答案”的角色:本身不直接学,只在固定间隔从在线网络复制一次参数;最终部署时,用的通常是在线网络(此时目标网络只是训练过程中的辅助品)。
Q7:在每一次训练 step 里,目标网络具体起什么作用?它在这一步是“被更新”还是“只被查询”?
在每一次训练 step 里,目标网络只做一件事:
根据下一步的状态,给出一个相对稳定的“未来价值估计”,用来构造当前这一步的学习目标。
它在这一小步中只是被查询,不更新参数;参数更新只发生在在线网络上,目标网络只在“同步时刻”整体被复制一次。
Q8:目标网络是如何“隔一段时间”更新的?什么是硬更新(Hard Update)?什么是软更新(Soft Update)?
硬更新:每隔固定步数 (比如 1000 步),直接把在线网络的参数完整复制给目标网络,相当于把旧参考答案整本撕掉,甩给你一本刚印好的全新参考答案。
软更新:每一步训练后,都把在线网络的参数倒给目标网络一小点,相当于参考答案本每次只换几页,每次掺和一点新内容,慢慢跟着学生的最新水平一起升级。
软更新公式为每步让目标网络参数 = (1-τ)×目标 + τ×在线 (τ≈0.001) ,就是原 0.999 的目标参数 +0.001 在线参数,构成最新目标网络参数。
Q9:实际实现中,“过一阵子再更新目标网络”通常是根据什么来判断的?是看模型表现好坏,还是用固定步数规则?为什么?
实际中,基本都是用“固定步数规则”,比如每走 C 个环境步或每训练 C 次,就更新一次目标网络,而不是根据“当前表现好不好”来决定。
原因是:损失或奖励本身就有很大波动,用它们来动态决定什么时候更新目标,会让整个训练逻辑非常复杂且不稳定;固定步数简单可控,更容易通过实验找到合适的节奏。
Q10:如果目标网络更新得太频繁 / 太不频繁,各自会带来什么问题?直觉上应该怎么选这个更新间隔 C?
更新太频繁:目标网络几乎每次都跟在线网络同步,目标值也跟着乱跳,等于没起到“固定一段时间的参照物”的作用,训练容易震荡。
更新太不频繁:目标网络长期停留在“很早的老版本”,在线网络一直在追一个过时的目标,学得慢,甚至方向不太对。
直觉上,C 要大到能让在线网络在当前目标下优化一阵子(几千到几万步),又不能大到让目标完全脱节;实际一般直接用经验值(比如文献或开源实现中的 C)作为初始选择,再视情况调整。
ε-greedy 与训练稳定性
Q11:ε-greedy 中的 ε 为什么通常要“从大到小”逐渐减小,而不是一直固定?如果一直很大或一直很小会有什么后果?
因为刚开始还没有经验,所以要先冷启动, ε 值较高,尽可能发散性的进行探索,探索多种方案,后面发现了效果好的方案,就渐渐降低 ε 以减少随机性,在后期基本稳定后,就只采用少样探索,而多利用以趋于稳定。
一直很大,会导致模型不稳定,每次效果有很大偏差,时好时坏。
一直很小,会导致模型可能陷入局部最优解,永远在附近兜兜转转,找不到最佳方案。
Q12:在整体训练流程里,ε-greedy、经验回放和目标网络是如何配合,让 DQN 又能探索又能稳定学习的?可以用一两句话描述它们各自负责的“角色”吗?
ε-greedy(采集者):交互时注入随机性,保证经验池数据多样;
经验回放(稳定器):随机小批量采样,打乱时序、平均噪声,让训练平稳;
目标网络(参照系):短期固定未来价值估计,提供稳定学习目标。
配合逻辑:多样数据 → 稳定训练 → 可靠目标 → 策略提升。
训练与收敛直觉
Q13:为什么用 batch(小批量)从经验池采样来训练,会比“一条一条在线更新”更稳定?直觉上是怎么减小“噪声”的?
batch 相当于把多条经验池数据聚合,能很好平均单条噪点数据带来的影响,而一条一条在线更新相当于每一条新数据都能对结果产生影响,会导致很容易被噪声数据带偏,不具备统计意义。
Q14:DQN 在理论上是不是一定收敛?在实际训练中,我们更应该关注什么样的现象,来判断“训练还算正常”?
Q 值依据神经网络进行更新,本身就是黑盒操作,训练过程不透明,且 Q 值更新过程是用估计值更新估计值
新猜测 = (1-学习率) × 旧猜测 + 学习率 × (当下奖励 + 对未来的猜测),因为目标 Q 值和神经网络学习的 Q 值来自于同一个网络的估计 不能保证一定收敛。
实际训练过程中,有抖动是正常现象,只要整体趋势是向上的、最终训练效果算是高分,那就没有翻车。
Q15:什么时候硬更新,什么时候软更新?
在离散场景下使用硬更新居多,因为它调参简单,训练收敛快,比如 Atari 游戏,小车平衡杆等;
在连续场景下使用软更新居多,因为它动作空间太大,策略变化快,防止更新太慢训练崩掉,常应用于机械臂抓取,自动驾驶等领域。