融入个人理解的强化学习 Q-learning 理论及简单实现
什么是 Q-learning 算法?
假设我们在开发一款井字棋游戏,我们都知道井字棋由九宫格组成,及 3*3 的网格,我们想训练一款能够利于不败之地每步都精准定位的 AI,这个时候就可以用到 Q-learning 算法,
原理
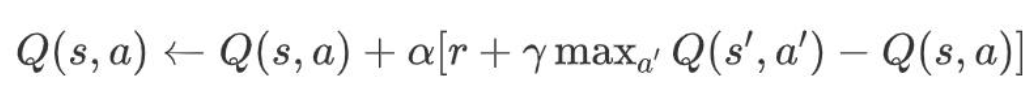
Q 值更新公式:新 Q 值 = 旧 Q 值 + 学习率α ×(当前奖励 + 折扣因子γ × 下个状态最大价值 Q - 旧 Q 值)。
Q-learning 说白了就是采样式、增量式的探索“**状态-动作对”,学习每个状态下采取每个动作的长期回报,从而选择出最佳路径的一种方法,它的本质就是不断更新一个值,即状态-动作值函数(Q 函数);但这也并不是遍历,并不会将全部路径都走一遍,而是通过试错和奖励反馈,维护一张状态-动作价值表 Q(s,a),通过贝尔曼最优方程(贝尔曼最优方程把在当前状态采取最优动作得到的奖励 与 折扣后的下一状态最优价值 之和,定义为当前状态的最优价值,从而不断的递归迭代,找到全局最佳方案)**的近似形式迭代更新 Q 值,最终收敛到最优策略。
既然是探索,那就具备随机性,因为如果直接使用贪心搜索,将会只关注当前最佳状态,而无法看到全局,这会导致永远无法找到最优路径,陷入局部最优解,那么针对这个问题,我们可以使用ε-greedy 来平衡探索和利用之间的关系。这种方法的好处就是可避免贪心搜索那样陷入局部最优解,永远找不到最优路径,因为贪心搜索只关注当前最优状态,而无法看到全局。
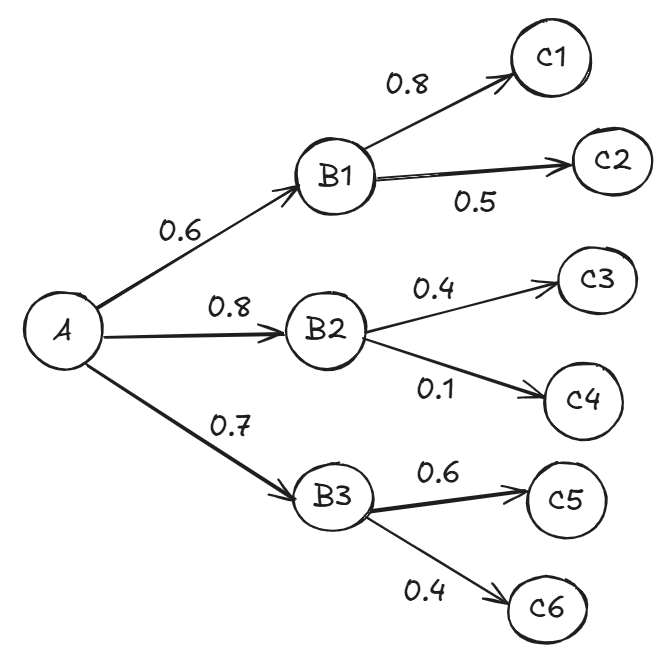
如图所示:
我们可以看到 3 条路径,这里想用贪心算法来找到“最短路径,每一步都走当前最小的一条路径,即 A–>B1–>C2 的方案,可我们明显能够看到,这样的话它的总体分值为 0.6+0.5=1.1,但这并非全局最优解,而很明显从全局角度来说 A–>B2–>C4 的方案才是全局最优方案,总分值为 0.8+0.1=0.9<1.1,使用贪心搜索的话可能永远无法找到最佳路径,因为它只关注局部最优,而忽略了整体结构。如下图方便理解:
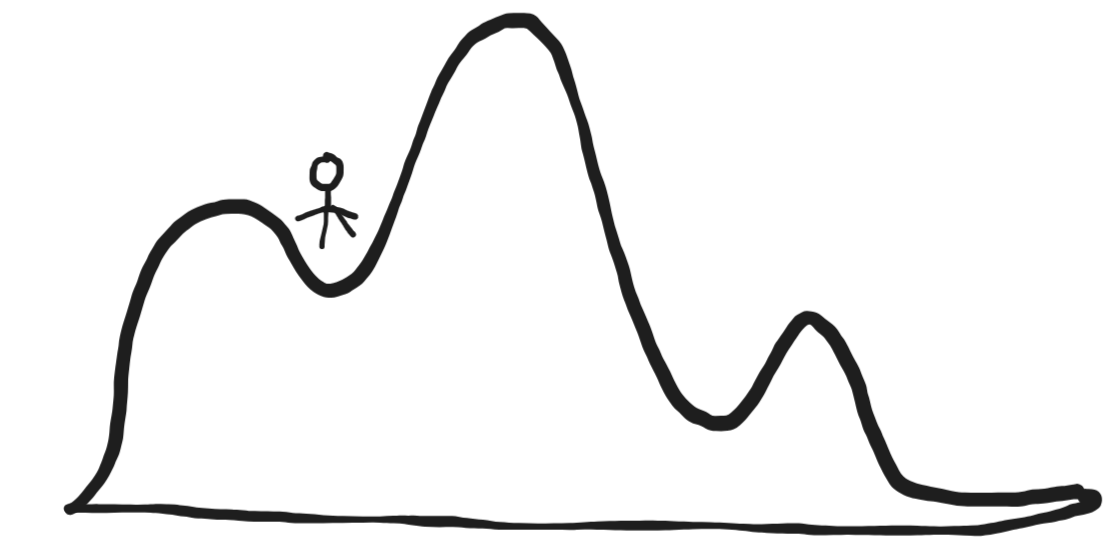
ε-greedy
ε-greedy 是强化学习中比较基础且重要的一个概念,它的思想类似抛硬币,抛得正面就探索新路线,反面就使用当前的探索出的最优道路,
- 正面(概率 ε)——把地图一扔,随便挑条没走过的路(探索)。
- 反面(概率 1−ε)——走他目前最熟、最快的固定路线(利用)。
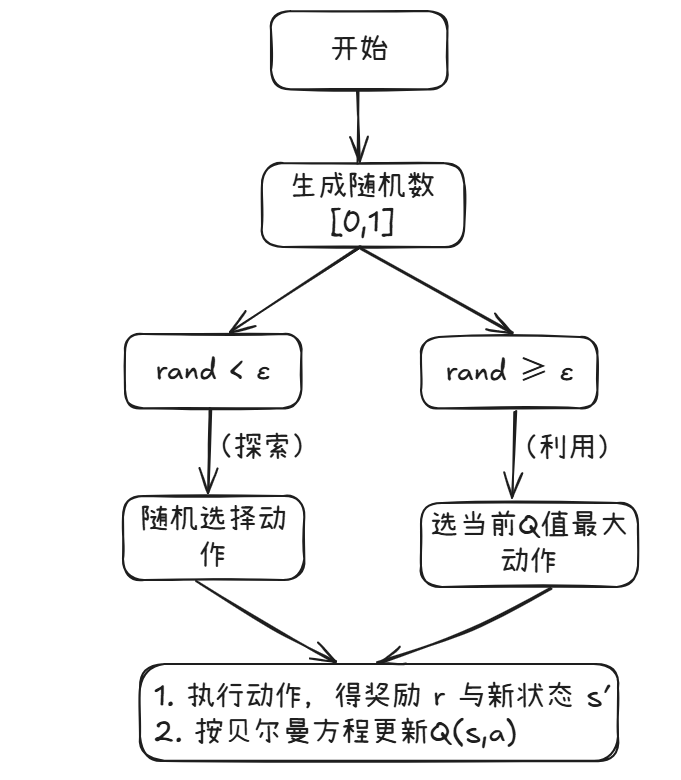
大部分时间走老路,确保稳定,少部分时间找找新路子,看看能不能有惊喜,通过这种方式就能帮助我们稳定地逐步迭代找到最佳路线。
ε-greedy 中的 ε 是一个 0–1 之间的数,假设ε = 0.5,则表示智能体有 50% 的概率随机选择动作,50% 的概率选择当前认为最优的动作。这个值的大小设定如果设置太大如 0.7,就会导致一直瞎探索找不到最佳规律,设定太小如 0.01,又会导致过于缓慢,所以通常设定 0.1 较为合适。
为了方便理解,我们这里也可大胆的将ε-greedy 的随机性类比为大模型生成文本时的“发散程度(temperature)
ε越高—>temperature 设定较高,输出越有创意与随机性 ε越低—>temperature 设定较低,输出越保守与可确定性
但是这里还需要澄清一点防止误解,大模型中的随机性参数 temperature 是由 softmax 的概率分布决定的,它决定模型整个输出 token 的平滑程度,每次模型输出时都会有候选 token,需要用候选 token 的原始分数/temperature,再做 softmax,这样最终输出结果会随着 temperature 的值的改变而发生影响
而ε-greedy 的随机性是由ε决定的均匀分布,只要确定好ε就是均匀抽奖,不会被 Q 值这些指标影响。但ε 本身可以随时间衰减(ε-decay),而 temperature 通常只在一次生成里起作用,不会自动衰减。
ε-greedy 衰减方法
而随着时间的延长,智能体已经能够总结经验发现规律,这时我们就应该减少初期的探索,而更加专注于利用,所以我们需要随着时间的衰减来逐步减少ε的大小**,这里通常有两种方式,即指数衰减、线性衰减。**
顾名思义
指数衰减就类似每次衰减*一个系数,比如老板发工资,系数为 0.1,原始工资为 100,今天发的工资为 100*(1-0.1)=90,明天发的工资为 90*(1-0.1)=81……,每天都会衰减但永远不会减到 0
而线性衰减就是每次减少固定值,如固定值为 1,今天发的工资为 100-1=99,明天就是 99-1=98,最少减到 10 块钱(留点底薪兜底防止崩溃)
公式如下:
eps = eps_start * (k ** t) # k∈(0,1),通常 0.995~0.999eps = eps_start - delta*t # δ 常用 (eps_start−eps_end)/T_max总结的话就是一个打折扣,一个减固定。
我也简单做了个基于 Q-learning 的井字棋 AI,可通过对弈不断进步更新(完整代码可后台回复 Q-learning 领取)
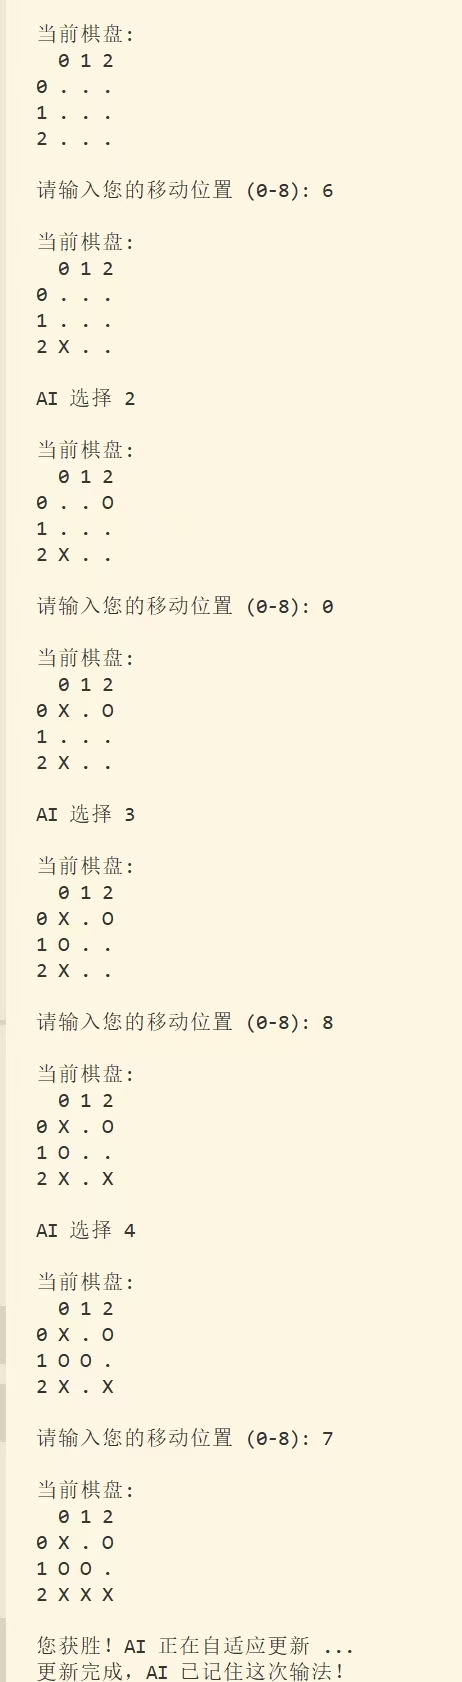
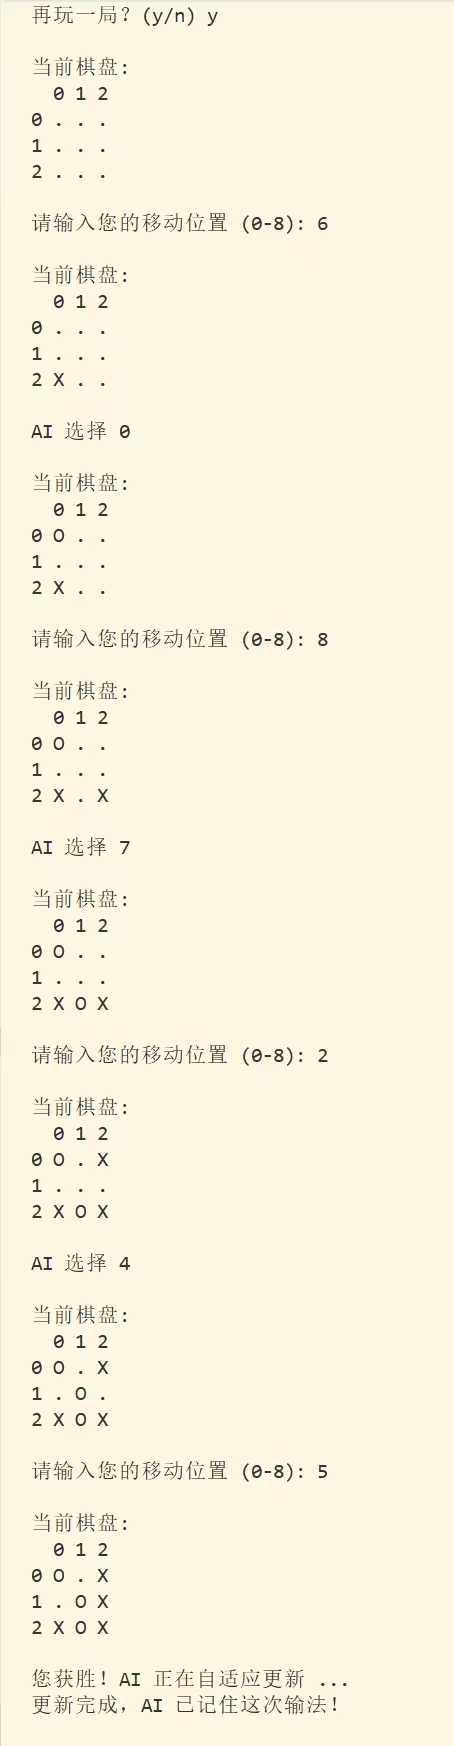
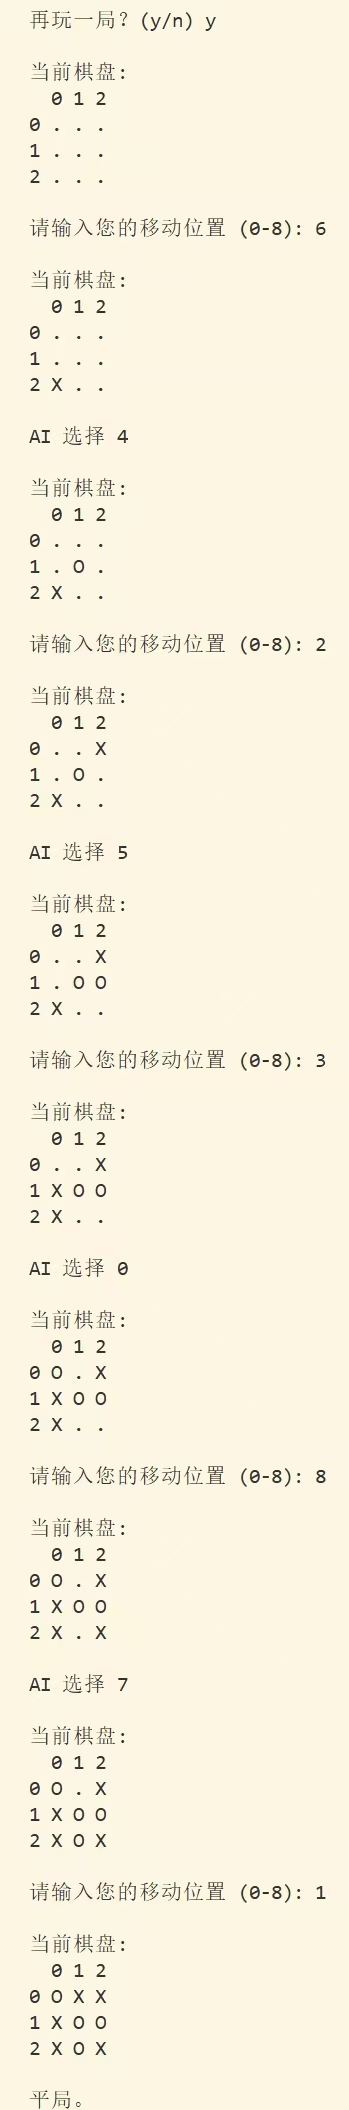
缺陷
而 Q-learning 也有不足之处,由于 Q-Learning 是一种无模型(model-free)的强化学习算法,需要通过不断更新 Q 表来学习最优策略。表格 Q-learning 本来就不是为“泛化”设计的,所以无法泛化,没见过的直接就是两眼一抹黑,同时由于每次需更新 Q 表,在面对如围棋象棋这类复杂场景下就会变得捉襟见肘,维度太高会造成维度爆炸,从而无法用正常的 Q 表来表示,计算的时间成本也会很高,在复杂场景下表现不好,想要通过它来落地的话也确实有点难绷。
针对复杂场景下的问题,后续的话采用如深度学习算法 DQN 等技术,采用函数近似代替暴力查表解决这类问题,本公众号也会逐步更新这方面知识,敬请期待!