大模型与深度学习
一文搞定迁移学习(上):核心思想与通用流程
核心观点
- 定义:迁移学习 (Transfer Learning) 是一种机器学习技术,它将一个在大型数据集(源任务)上预训练好的模型,应用到一个新的、相关的目标任务(通常数据量较少)上。
- 目标:解决目标任务训练数据不足的问题,同时提高训练效率和模型性能。
- 核心机制:复用预训练模型已经学到的通用特征提取能力(如图像的边、角、纹理),再通过少量新数据对模型的特定部分进行微调,使其适应新任务。
- 经典比喻:这种方法好比“站在巨人的肩膀上”,我们无需从零开始学习,而是基于前人已经总结好的知识进行再创造。
详细阐述
- 什么是迁移学习?
迁移学习是机器学习的一个重要分支。其核心思想是将在一个大规模数据集(如 ImageNet,包含上百万张各类图片)上训练好的模型(称为预训练模型,Pre-trained Model),将其学到的“知识”迁移到我们自己新的、数据量不足的相关任务上。
- 核心原理与流程
整个过程通常分为两个阶段:
-
预训练 (Pre-training):在一个庞大的、通用的数据集上训练一个深度神经网络(例如,一个在数千种物体图片上训练好的模型 A)。这个模型在训练过程中会学到从低级到高级的层次化特征。对于图像识别而言,底层网络可能学会识别颜色、边缘和纹理,而高层网络则可能学会识别更复杂的形状或物体部件。这些学到的权重 (W 和 b) 包含了关于数据世界的通用知识。
-
微调 (Fine-tuning):在预训练之后,我们便进入了关键的微调阶段。这个过程的精髓可以通过下图清晰地展现:当我们面临一个数据量较少的新任务时(例如,一个只有几百张牛羊图片的识别任务),我们不必从头开始。而是通过以下步骤对预训练模型(模型 A)进行微调,以得到最终为新任务量身定制的模型(模型 B):通过这个流程,最终得到的模型 B 就是一个在保留通用知识的同时,又具备了识别牛羊特定能力的高效模型。
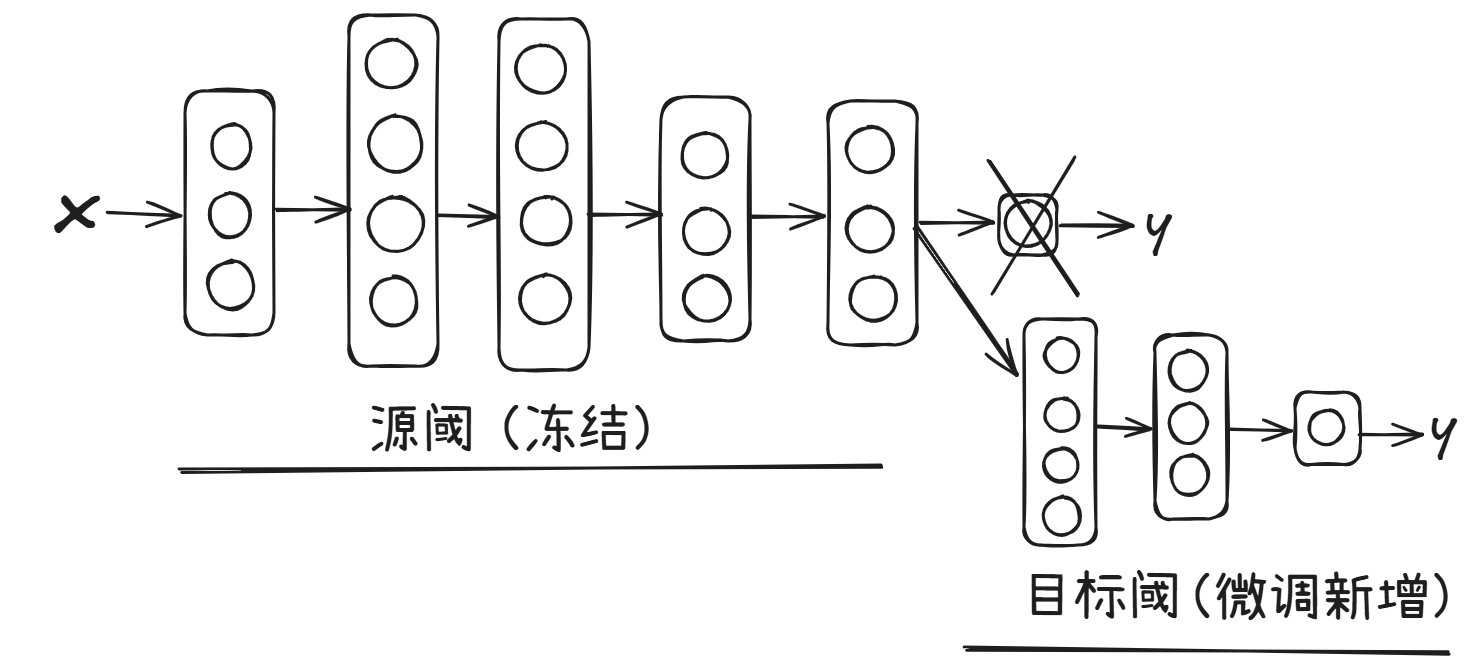
- 加载模型并冻结主干:我们首先加载预训练模型 A,并将其大部分网络层冻结。这些被冻结的层将作为固定的“特征提取器”,保留其从大规模数据中学到的通用知识(如识别边缘、纹理和形状)。
- 改造模型头部:接着,我们移除模型原有的、针对源任务的输出层(即“头部”),并替换为一个为新任务定制的、未训练的新头部。例如,将一个能识别 1000 种物体的分类器,换成一个只识别“牛”和“羊”的二分类器。
- 训练新头部:在训练阶段,我们只更新这个新增头部的参数。由于只需训练少量参数,这个过程非常高效,能让模型快速学习如何利用前端提取的通用特征来完成新任务。
- (可选)整体微调:对于更复杂的任务,可以采取一种更灵活的策略来追求更高性能。即在完成上述步骤后,解冻预训练模型的最后几个高层网络,并用一个极小的学习率对它们进行同步训练。这能让模型的高级特征也更好地适应新数据,但会增加模型复杂度和过拟合的风险。
- 何时应该使用迁移学习?
迁移学习并非万能,在以下场景中它会表现得尤为出色:
- 目标任务数据量小:当你的新任务只有几百或几千个样本,不足以从零开始训练一个复杂的深度模型时,迁移学习是最佳选择。如果数据量足够大(如数万、数十万),从头训练可能效果更好。
- 源任务与目标任务相关:预训练模型所用的数据类型应与新任务一致。例如,在图像领域(图像到图像)、自然语言处理领域(文本到文本)或音频领域(音频到音频)进行迁移,效果会非常显著。如果源任务和目标任务毫不相关(如用图像模型去处理文本),迁移学习将失去意义。
- 源任务数据规模远大于目标任务:预训练模型必须在比目标任务数据量大得多的数据集上训练,这样它学到的通用特征才足够丰富和稳固。
总结
总而言之,迁移学习是一种高效且强大的技术。它通过复用一个强大模型已经学到的知识,让我们能够用较少的数据和计算资源,快速构建出在特定任务上表现优异的新模型。其中,我们利用的模型 A 就是预训练模型,而基于它构建新模型 B 的过程就是微调。