简单科普什么是机器学习无监督两兄弟
开头引入
你有没有想过,为什么淘宝总能精准推荐你想要的商品?为什么地图 App 能准确识别拥堵路段?背后的秘密就是聚类算法!
今天我们用最简单的方式,揭秘两大经典聚类算法的奥秘。不需要复杂的数学公式,只要你上过学、加过微信群,就能秒懂!
什么是聚类?
简单来说,聚类就是“物以类聚,人以群分”的数字化实现。想象一下整理衣柜:你会把 T 恤放一堆,裤子放一堆,这就是聚类的思想。计算机也是这样,通过分析数据的相似性,自动把相似的数据归为一类。
为什么要学聚类?
- 电商推荐:把相似购买行为的用户归类,实现精准营销
- 社交分析:发现朋友圈里的小团体,推荐可能认识的人
- 城市规划:分析人流热点,优化商圈布局
- 医疗诊断:根据症状相似性辅助疾病分类
接下来我们讲讲聚类中比较典的两兄弟:k-means 和 dbscan。
K-means
K-means 聚类的目标是将数据分成 k 个簇。算法开始时随机初始化 k 个质心点,比如我们要分 2 类就放置红色和蓝色两个质心。接下来计算每个数据点到各个质心的距离,距离越小说明越相似,通过遍历所有数据点进行分配:离红色质心近的归为红类,离蓝色质心近的归为蓝类。
当发现分类效果不理想时,算法会重新调整质心位置。具体做法是:将所有红色点的坐标取平均值计算出新的红色质心,同样计算蓝色质心的新位置。然后用新的质心重新遍历所有数据点,原来属于红色的点可能因为离蓝色质心更近而被重新分配到蓝色簇中。这个过程会持续迭代优化,直到所有样本点的归属不再发生变化,算法收敛完成,就结束了。
优点:
- 简单快速:算法思路直观,实现简便,适合常规数据集处理
缺点:
- k 值选择困难:参数 k 需要人工设定,通常要尝试多组数值来观察效果
- 计算复杂度高:时间复杂度与样本数量呈线性关系,每次迭代都要计算所有样本到质心的距离,面对几千万样本时计算负担沉重
- 形状适应性差:很难发现任意形状的簇,无法有效处理环形、月牙形等不规则形状的数据分布
- 初值敏感性:由于质心初始化是随机的,每次运行结果可能差异很大,初始值对最终结果影响显著
每一次差异都比较大,初值会对结果产生很大影响
DBSCAN
DBSCAN 是一种基于密度的聚类方法,它不需要预先指定簇的数量,而是通过分析数据点的密度分布来自动发现簇。算法的核心思想很简单:密集的地方自然形成一个群体,稀疏的地方就是边界或噪声。
具体来说,DBSCAN 需要你设定两个参数:邻域半径(eps)和核心点周围的最少点数(min_samples)。算法首先扫描所有数据点,找出那些在指定半径内包含足够多邻居的“核心点”。然后从任意一个核心点开始,像滚雪球一样把所有能够密度连通的核心点都拉进同一个簇里。这就像朋友圈的扩散:张三认识李四,李四认识王五,他们自然就形成了一个紧密的小团体。
对于那些不够“受欢迎”的非核心点,它们的命运比较被动:如果恰好在某个核心点的势力范围内,就会被拉入相应的簇中,但它们没有资格去拉拢其他人,只能当个“跟班”。用同样的策略,算法会陆续发现其他的簇。最终,那些既不是核心点、又无法投靠任何团体的孤独分子,就被标记为噪声点或离群点,它们注定要独自美丽。
优点:
- 不用猜簇的个数:K-means 需要你提前说要分几类,DBSCAN 会自己根据数据的聚集程度来决定分几个群体,完全不用你操心
- 什么形状都能处理:不管数据长得多奇怪,是弯弯曲曲的还是环形的,只要够密集就能找出来,K-means 只能处理圆圆的数据团
- 会自动踢出捣乱分子:那些明显不合群的异常数据点,DBSCAN 会直接标记为噪声扔掉,不会硬塞到某个组里影响整体效果
- 结果很稳定:每次跑出来的结果都一样,不像 K-means 每次随机初始化导致结果不同
缺点:
- 参数不好调:那两个参数 eps 和 min_samples 怎么设置完全靠经验和感觉,新手很容易调得乱七八糟
- 处理不了密度差异大的数据:如果有些地方人很多,有些地方人很少,用一套标准很难同时处理好,要么漏掉稀疏的群体,要么把噪声当成群体
- 高维数据就歇菜了:数据特征太多的时候,距离的概念就模糊了,算法基本失效
- 计算量比较大:需要算每个点和其他点的距离,数据量大的时候会比 K-means 慢不少
总的来说,DBSCAN 就像个挑剔的社交达人,对于复杂的人际关系很有一套,但对环境要求比较高,遇到不合适的场景就不太行了。
简单举个例子的话就是
K-means 就像学校分班:
- 校长预先决定分几个班(k 值)
- 随机指定几个临时班长位置
- 学生选择离自己最近的班长
- 每个班重新选出“中心学生”当新班长
- 重复直到班级稳定
DBSCAN 就像自然形成的朋友圈:
- 人缘好的(核心点)自然成为圈子中心
- 朋友的朋友也是朋友(密度连接)
- 性格孤僻的就是独行侠(异常点)
- 不需要预先决定要几个圈子
选择 K-means 当:
- 你大致知道要分几类
- 数据分布相对规整(球形)
- 追求计算速度和简单性
- 异常值较少
选择 DBSCAN 当:
- 不知道要分几类
- 数据可能有复杂形状
- 存在大量噪声和异常值
- 想要自动发现数据的自然结构
算法对比
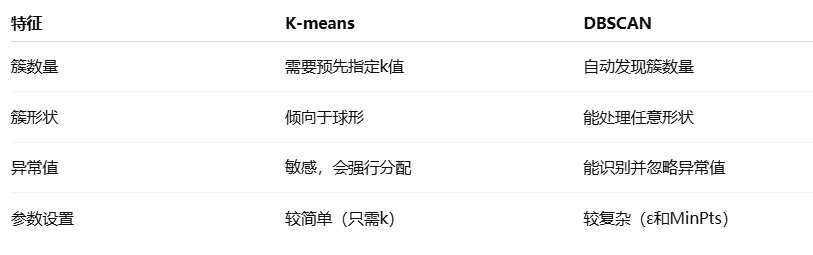
总而言之这两种算法各有所长,K-means 适合“规整”的数据,DBSCAN 适合“复杂”的现实场景。选择哪个主要看你的数据长什么样子和想解决什么问题!