LoRA,P-Tuning 微调原理
微调基础概念
在大语言模型中,微调是一种帮助模型学会新知识的一种方式。如果你的微调数据集包含了特定领域的新信息,模型在训练过程中就会学习这些内容,并将其融入到自己的响应中。事实上,微调确实能够教会模型新的知识与规律。
训练范式与 RAG 对比
典型训练范式为:预训练 + 监督微调 + RLHF(人类反馈强化学习)。微调的优势在于内化知识,无需 RAG 实时检索外部知识库,响应更快。但 RAG vs 微调无绝对优劣——RAG 数据洗得好切的好,切片质量高,检索方式到位时效果优秀;而微调翻车多是因为超参数不适配数据规模,调优参数能显著提升性能。
主流微调方法概览
微调,一般是采用 P-Tuning 和 LoRA,QLoRA 微调这几种主流方式,(全参微调更新全部参数,效果最佳但资源消耗巨大。) .
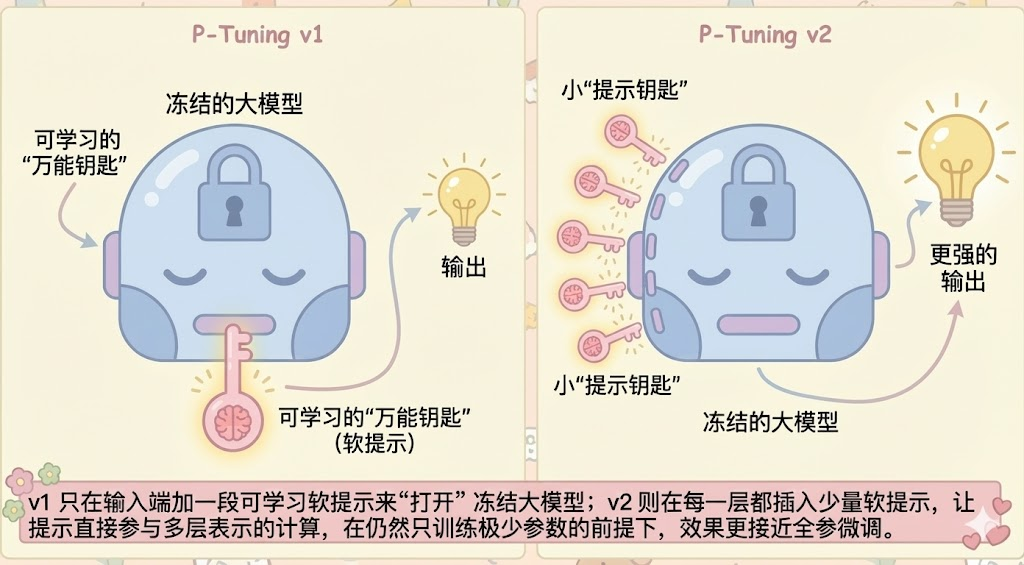
P-Tuning
P-Tuning v1 版本,在输入层前插入一组可训练的连续向量(称为“软提示”)相当于加了一层 prompt,通过这种方式来提高模型性能
P-Tuning v2 版本,在每一层的前缀位置注入独立的可训练 prompt,每层独立的软提示可以独立学习任务特征,从而更高效的提升模型性能
LoRA 核心原理
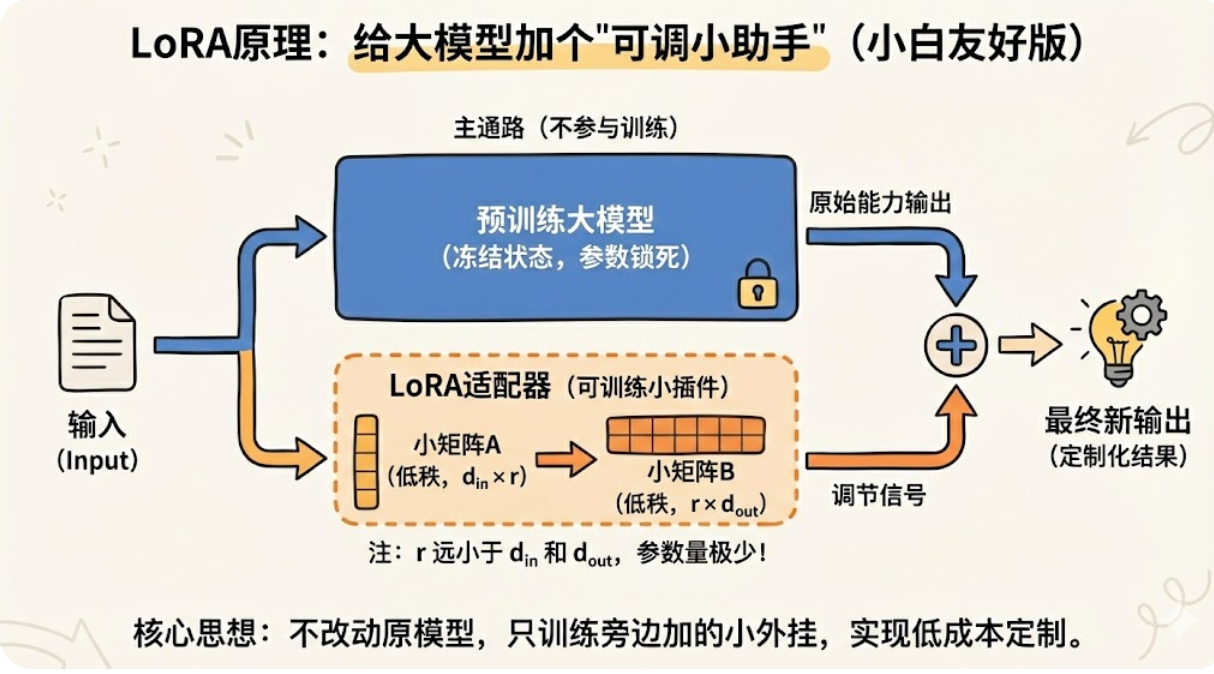
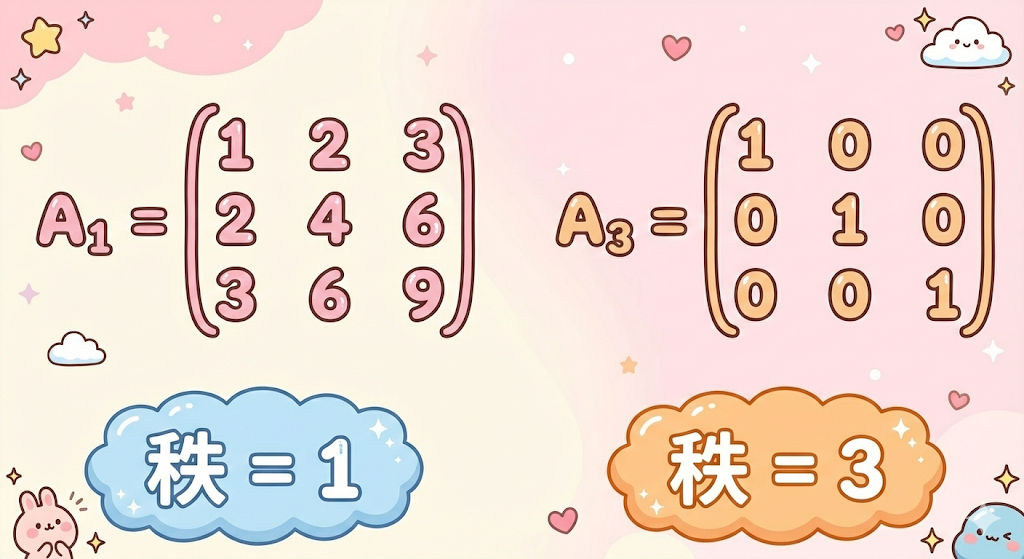
lora 的本质就是低秩分解,什么是秩?一个矩阵中线性独立的行或者列,就是秩,可以认为,一个矩阵的秩越大,它包含的信息就越全面,能够描述的空间越大。
大白话就是说,一个 3×3 矩阵的最大秩是 3,当它的秩为 1 时,说明所有行(或列)都可以由一行(或一列)的线性组合得到,信息被极度压缩。
LoRA 并不直接去更新原来的完整权重矩阵,而是在它旁边增加一个“旁路”结构,用两个可训练的小矩阵 A(3×1)和 B(1×3)来表示权重变化。
这样一来,模型只需训练这 6 个参数,而不是原矩阵的 9 个参数,就能实现同样的微调效果,大大降低了计算资源消耗。
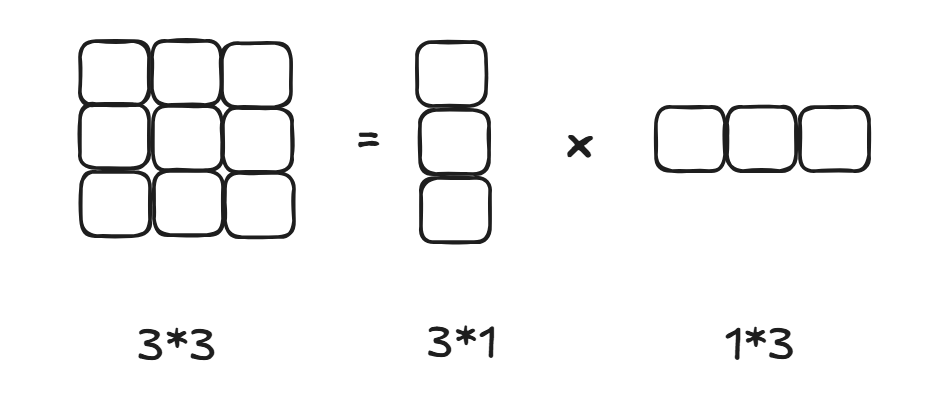
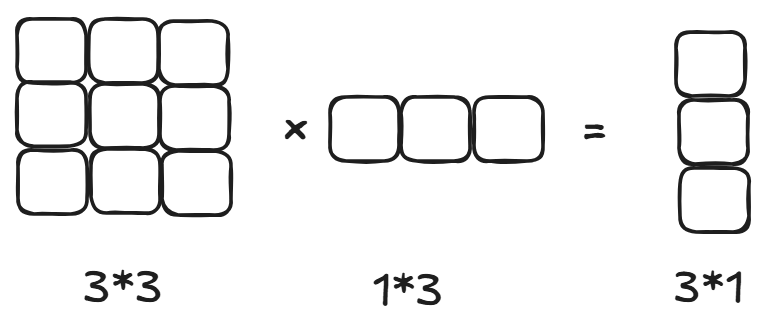
旁路矩阵示意图
如图,两个小矩阵可得到一个大矩阵,同样的,一个大矩阵*一个小矩阵,也可以通过矩阵乘法得到一个小矩阵。
通过旁路矩阵进行训练,训练好后的参数+上原本的完整权重。
最终输出 = 原权重计算结果 + LoRA 旁路计算结果
h = (W₀ × x) + (B × A × x) / α
↑ ↑
原模型输出 旁路补丁输出
其中 h 为最终输出,W0 为原始冻结参数,x 为输入,A,B 为两个旁路矩阵,α是缩放系数,控制旁路矩阵输出幅度(让输出数值别太大别太小)
QLoRA 量化优化
QLoRA 就是在原来 LoRA 的基础上,对全参数矩阵进行量化操作,使原始模型变得更小,占用更少资源,用少量精度换取性价比高的结果。
总结:
全参微调:假设原始模型参数量为 100*100,全参微调需更新的参数量就是 100*100 = 10000
LoRA 微调:
-
冻结原表格(100×100,不动它)
-
加两个小表格(旁路矩阵):
- A 表:100 行×4 列 = 400 参数
- B 表:4 行×100 列 = 400 参数
-
计算公式:最终输出 = 原表格 + (A × B 的结果),4 就是 LoRA 的“秩”(rank)。
QLoRA 微调:
-
把原表格进行量化(float 转 int 的过程),压缩成 4bit 版本(从 10,000 高精度浮点数压成 3,000 个 4bit 整数码)
- 存储只需原先 1/4 空间,在需要的时候将全参矩阵“解码”回 FP16 计算。
-
冻结这个瘦版表格
-
再加 LoRA 的 A、B 小表格(同上,800 参数)
LoRA(低秩适应机制)——仅对一小部分额外的“适配器”权重矩阵进行微调(这些权重矩阵以 16 位精度进行存储),省时省力,显著减少训练过程中需要更新的参数数量。
QLoRA(量化 LoRA)——在 LoRA 基础上,先将原始模型权重压缩为 4 位 NF4 量化格式(存储只需原先 1/4 空间),冻结后仅训高精度 LoRA 适配器,这样可以显著降低内存消耗与计算开销。