机器学习
ballTree
当你想要计算出某一点和所有库存点中距离最近的一个点时,最简单的方法无非就是遍历,暴力计算所有点的距离,最小的即是当前所要找的点。但是这样涉及到一个问题,这个点都需和全量的所有点进行计算,这样会费时间和计算资源,
而balltree正是解决当前这种问题的一种方式。
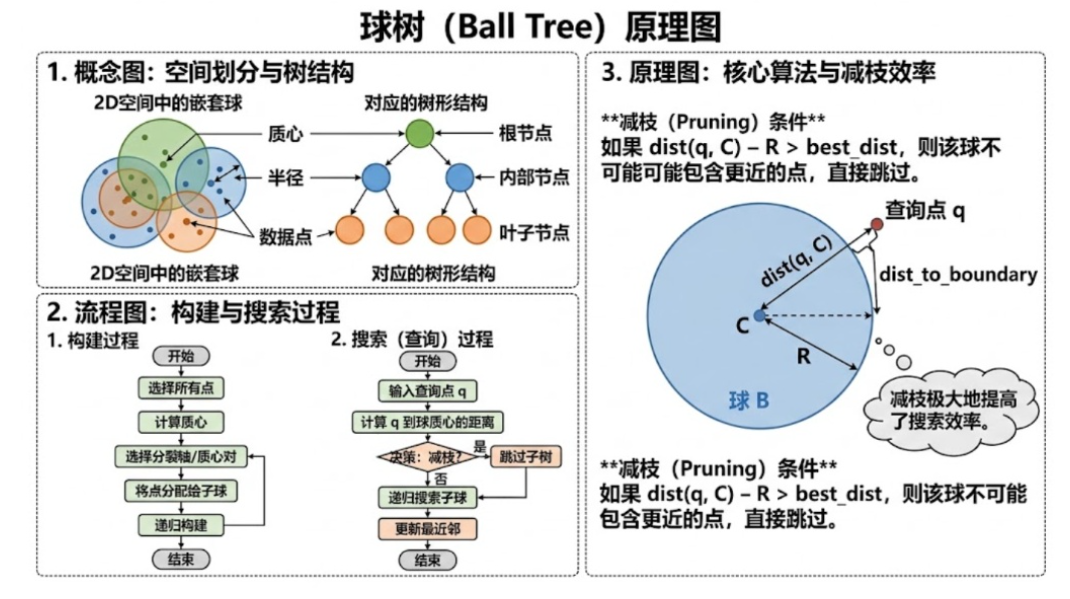
balltree是怎么做的?
它并不直接去计算点,而是先构建球形树,把所有的划为一个球,然后分左右球,球再逐渐分化,直到几个节点为树,我们只需记录各自的球心以及半径。
在一个点需要计算时,先和左右球的中心点进行计算,减去半径,即是这个点最有可能接近某个球,然后再到球里在进行分化计算。左球近,就进左球,相当于整个右球直接剪枝操作。
这样有一个好处,如果你想计算100w条采样点,左球有80w条采样点,右球有20w,如果计算出距离左球更近,那么右球20w就可直接跳过不予计算(假设左子树里我们已经找到了一个很近的候选点。此时如果右子球从几何边界上就能判断:它里面不管哪个点,都不可能比这个候选点更近,那么右子树这 20w 个点就可以整块剪枝,完全不用算距离),这无疑是一种巨大的提升,时延降低率很高。
全部数据
↓
分成两组
↓
每组再分成两组
↓
直到叶子
这种球套球,类似RAG中的父子向量块查询,只不过RAG是检索子块认为与当前query相似,去父块找更多上下文进行补充,而balltree与之相反,通过定位当前大球距离比其他球更近,进一步计算当前大球内的子球内的距离,直到最内部的叶子节点,只需枚举一下,即可快速找到要寻找的最近采样点。