Generative AI Fundamentals 生成式人工智能基础知识
生成式人工智能基础知识
机器学习技术已经存在数十年了,这不禁让人发问:是什么促成了生成式人工智能的兴起?答案其实很简单:巨额资源投入。组建庞大的团队、投入计算资源,以及至关重要的——愿意投资并开发创新理念,这些都是生成式人工智能崛起的重要因素。
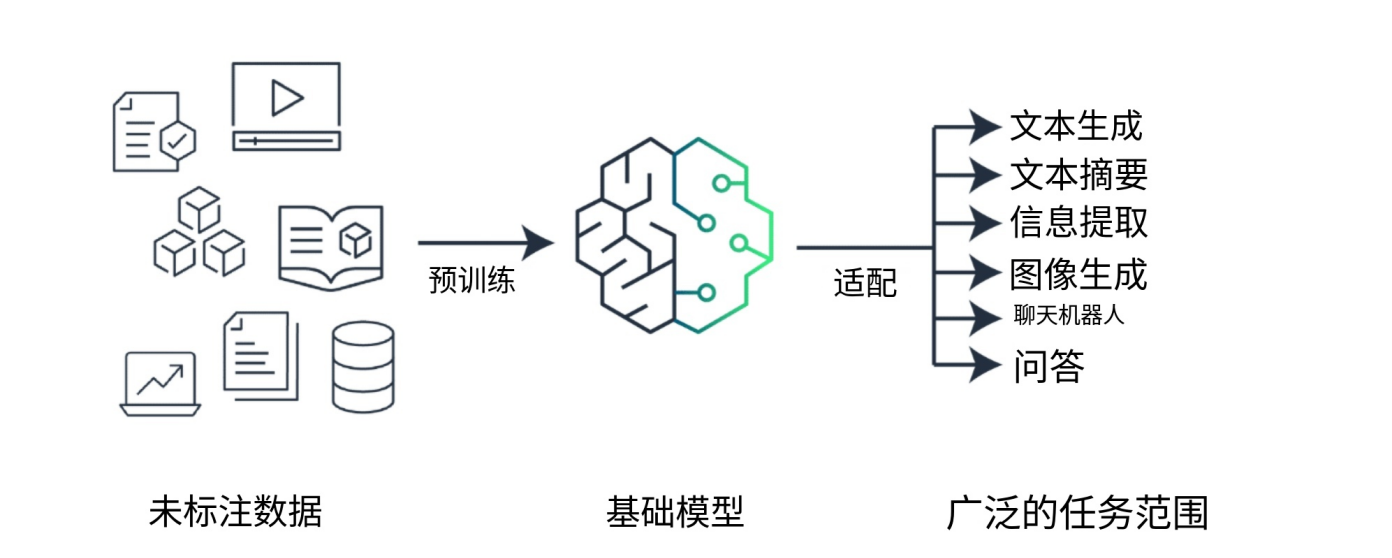
生成式人工智能由在互联网规模数据上预训练的模型驱动,这些模型被称为基础模型(FM)。与传统机器学习需要为每个模型收集标注数据并训练多个模型不同,使用基础模型可以调整单个基础模型以执行多种任务。这些任务包括文本生成、文本摘要、信息提取、图像生成、聊天机器人交互和问答。基础模型还可以作为开发更专业化模型的起点。
基础模型生命周期是一个综合过程,涉及多个阶段,每个阶段在开发和部署有效可靠的基础模型中都发挥着至关重要的作用。
1.Data selection 数据选择
由于未标记数据比已标记数据更容易获取,因此可以大规模用于预训练。未标记数据包括原始数据,例如图像、文本文件或视频,这些数据没有任何有意义的标签来提供上下文信息。功能模型需要使用来自不同来源的海量数据集进行训练。
2.Pre-training 预训练
尽管传统的机器学习模型依赖于监督学习、无监督学习或强化学习模式,但功能模型通常通过自监督学习进行预训练。自监督学习不需要带标签的样本,它利用数据内部的结构自动生成标签。
在初始预训练阶段,FM 算法可以学习数据集中词语的含义、上下文和相互关系。例如,模型可以学习“drink”是指名词“饮料”,还是动词“吞咽液体”。
完成初始预训练后,模型可以使用更多数据进行进一步预训练,这被称为持续预训练。其目标是扩展模型的知识库,并提高其在不同领域或任务中的理解和泛化能力。
3.Optimization 优化
预训练语言模型可以通过提示工程、检索增强生成(RAG)以及基于特定任务数据的微调等技术进行优化。这些方法的复杂性和成本各不相同。
4.Evaluation 评估
无论是自行微调模型还是直接使用预训练模型,下一步合乎逻辑的做法都是评估模型。模型性能可以通过适当的指标和基准来衡量。评估模型性能及其满足业务需求的能力至关重要。
5.Deployment 部署
当模型模型满足预期性能标准后,即可将其部署到目标生产环境中。部署可能涉及将模型集成到应用程序、API 或其他软件系统中。
6.Feedback and continuous improvement 反馈与持续改进
部署后,模型性能会持续受到监控,并收集来自用户、领域专家或其他利益相关者的反馈。这些反馈连同模型监控数据,用于识别需要改进的领域、检测潜在的偏差或漂移,并为模型的后续迭代提供信息。这种反馈循环允许根据需要,通过微调、持续预训练或重新训练来不断增强基础模型。
7.Summary 概括
值得注意的是,设施管理生命周期是一个迭代过程,从每个阶段吸取的经验教训和获得的见解可以为后续迭代提供信息和改进。
要理解生成式人工智能的能力,有几种类型的功能模型至关重要。
Large language models 大型语言模型
大型语言模型(LLM)可以基于多种架构,但目前最先进的模型中最常用的架构是 Transformer 架构。基于 Transformer 的 LLM 是功能强大的模型,能够理解和生成类似人类的文本。它们利用来自互联网、书籍和其他来源的大量文本数据进行训练,并学习词语和短语之间的模式和关系。
为了更好地理解 LLM 的工作原理,需了解标记、嵌入和向量。
TOKENS
词元是模型处理文本的基本单元。词元可以是单词、短语或单个字符,例如句点。词元还实现了输入数据的标准化,从而使模型更容易处理数据。
例如,“小狗之于狗,如同小猫之于猫。”这句话可以拆分成以下几个词素:“A” “puppy” “is” “to”“dog” “as” “a”“kitten” “is” “to” “cat”。
语言学习模型(LLM)利用这些词元、词嵌入和向量来理解和生成文本。这些模型能够捕捉语言中复杂的关联关系,因此可以生成连贯且符合语境的文本,回答问题,总结信息,甚至进行创意写作。
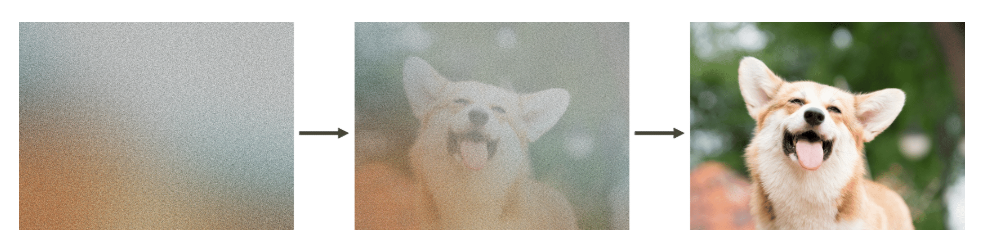
扩散模型是一种深度学习架构系统,它从纯噪声或随机数据开始。模型会逐步向这些噪声中添加越来越多的有意义信息,直到最终生成清晰连贯的输出,例如图像或文本。扩散模型通过正向扩散和反向扩散两个步骤进行学习。
Forward diffusion 前向扩散
利用前向扩散,该系统逐渐向输入图像引入少量噪声,直到只剩下噪声为止。
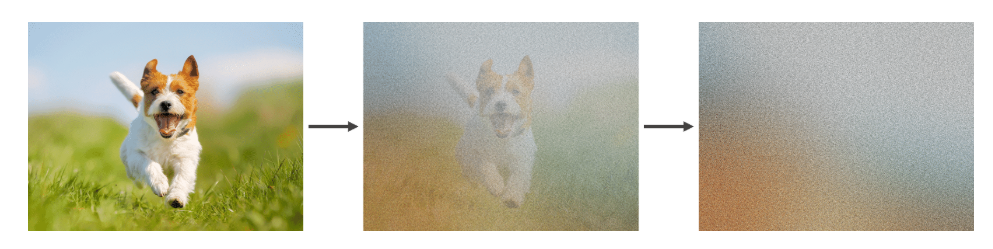
Reverse diffusion 逆扩散
在随后的反向扩散步骤中,逐渐将噪声图像引入去噪过程,直到生成新的图像。
尽管扩散模型最著名、最令人印象深刻的应用之一是文本到图像模型,但扩散模型还可以应用于图像生成以外的各种任务。
Multimodal models 多模态模型
多模态模型并非仅依赖单一类型的输入或输出(例如文本或图像),而是可以同时处理和生成多种模式的数据。例如,多模态模型可以接收一张图片和一些文本作为输入,然后生成一张新图片和一段描述该图片的文字说明作为输出。
这类模型能够学习图像和文本等不同模态之间的联系以及它们如何相互影响。多模态模型可用于自动生成视频字幕、根据文本指令创建图形、结合文本和视觉信息更智能地回答问题,甚至在保留相关视觉元素的同时翻译内容。
Other generative models 其他生成模型
Generative adversarial networks 生成对抗网络(GAN)
生成对抗网络(GAN)是一种生成模型,它包含两个在零和博弈框架下相互竞争的神经网络。这两个网络分别是生成器和判别器。
生成器: 该网络通过接收随机噪声作为输入,并将其转换为类似于训练数据分布的数据,从而生成新的合成数据(例如图像、文本或音频)。
判别器: 该网络以训练集中的真实数据和生成器生成的合成数据作为输入。其目标是区分真实数据和生成数据。
在训练过程中,生成器试图生成能够欺骗判别器使其误认为真实数据的数据,而判别器则试图正确区分真实数据和生成的数据。这种对抗过程持续进行,直到生成器生成的数据与真实数据无法区分为止。
Variational autoencoders (VAEs)
变分自动编码器 (VAE)
VAE 是一种生成模型,它结合了自编码器(一种神经网络)和变分推断(贝叶斯统计中的一种技术)的思想。在 VAE 中,模型由两部分组成:
编码器: 该神经网络接收输入数据(例如图像),并将其映射到低维潜在空间,从而捕捉数据的基本特征。
解码器: 该神经网络从编码器获取潜在表示,并生成原始输入数据的重构。
VAE 的关键在于鼓励潜在空间遵循特定的概率分布(通常是高斯分布),从而可以通过从该潜在空间采样并将样本传递给解码器来生成新数据。
Optimizing model outputs 优化模型输出
基础模型生命周期的关键部分是优化阶段。FM 可以通过多种方式进一步优化。这些技术在复杂度和成本上各不相同,最快且成本最低的选择是提示工程。
Prompt engineering 提示工程
提示词作为基础模型的指导。提示工程专注于开发、设计和优化提示,以提升你需求的 FM 输出。它为你提供了引导模型行为达到你想要实现的结果的方式。
提示词的形式取决于你交付给模型的任务。在探索提示工程示例时,你将审查包含以下部分或全部元素的提示:
指令 :这是 FM 要完成的任务。它提供了模型应如何执行的任务描述或指令。
上下文 :这是指导模型的外部信息。
输入数据 :这是你想要得到响应的输入。
输出指示器 :这是输出类型或格式。
以下是一个可以提供给 FM 的提示示例。
Example prompt  示例提示词
你是一位经验丰富的记者,擅长将长篇文章浓缩成简明扼要的摘要。请用2到3句话总结以下文本。
正文:[长文内容在此]
Fine-tuning 微调
虽然 FM 通过自我监督学习进行预训练,并具备理解信息的固有能力,但微调 FM 基础模型可以提升性能。微调是一种监督学习过程,涉及将预训练模型添加具体且较小的数据集。添加这些更窄的数据集可以调整数据权重,使其更好地符合任务。
微调模型有两种方法:
Instruction fine-tuning uses examples of how the model should respond to a specific instruction. Prompt tuning is a type of instruction fine-tuning.
指令微调 通过示例说明模型应如何响应特定指令。提示调优是一种指令微调。
Reinforcement learning from human feedback (RLHF) provides human feedback data, resulting in a model that is better aligned with human preferences.
来自人类反馈的强化学习(RLHF)提供人类反馈数据,从而形成更符合人类偏好的模型。
请考虑这个微调的用例。如果你正在处理需要行业知识的任务,你可以用预训练模型,并用行业数据微调模型。例如,如果任务涉及医学研究,预训练模型可以结合医学期刊的文章进行微调,以获得更具上下文化的结果。
Retrieval-augmented generation检索增强生成(RAG)
检索增强生成(RAG) 是一种技术,通过提供与领域相关的数据作为上下文,从而基于这些数据生成响应。这种技术类似于微调。然而,RAG 无需通过少量带标签的示例微调 FM,而是获取少量相关文档,并利用这些文档提供上下文以回答用户提示。RAG 不会改变基础模型的权重,而微调则会改变模型权重。