xgboost 理解
为了理解 XGBoost,我们需要对监督分类、决策树和提升算法等更广泛的概念有所了解,这些内容将在本章中详细介绍。首先,让我们简要回顾一下……
监督学习与分类问题
本文将介绍监督学习及其方法可以应用于哪些类型的问题。监督学习的核心(XGBoost 可以应用于此类学习问题)依赖于标记数据。也就是说,你需要对试图解决的问题或试图预测的结果的历史行为有所了解。
例如,判断特定图像中是否包含人脸就是一个分类问题。这里的训练数据是转换为像素值向量的图像,标签为 1(表示图像包含人脸)或 0(表示图像不包含人脸)。由此可见,监督学习问题主要分为两类:分类问题和回归问题,它们涵盖了绝大多数的应用场景。本文仅讨论分类问题,回归问题将在第二章中介绍。
分类问题涉及预测二元或多类结果。
例如,根据报价预测某人是否会购买保险套餐就是一个二元监督学习问题。
预测图片中是否包含几种鸟类中的一种,是一个多分类监督学习问题。而处理二元监督学习问题时,
AUC,即受试者工作特征曲线下面积,是评估二元分类模型质量最通用、最常用的指标。它简单来说就是:对于你的学习问题,随机选择一个正样本数据点,其排名高于随机选择一个负样本数据点的概率。因此,AUC 值越高,意味着模型越灵敏、性能越好。在处理多类分类问题时,通常使用准确率(越高越好)并查看整体混淆矩阵来评估模型的质量。
一些常见的分类算法包括逻辑回归和决策树。如果您想深入了解,可以查看 DataCamp 的监督学习入门课程。
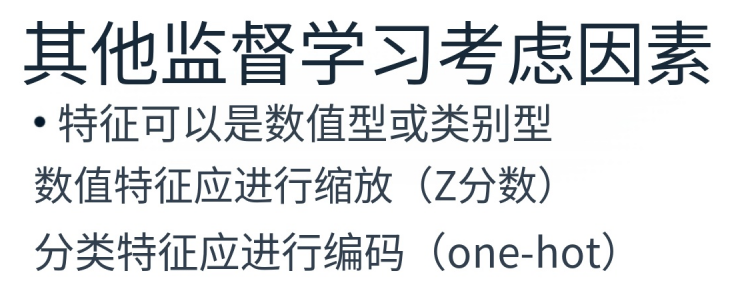
所有监督学习问题,包括分类问题,都要求数据结构化为特征向量表,其中特征(也称为属性或预测因子)可以是数值型的,也可以是类别型的。此外,通常需要对数值型特征进行缩放,以帮助解释特征或确保模型能够正确训练(例如,数值型特征缩放对于确保支持向量机模型的正确训练至关重要)。类别型特征几乎总是在应用监督学习算法之前进行编码,最常用的是独热编码。最后,还存在其他类型的监督学习问题,因此我将在此简要提及。
排名问题涉及预测一组选项(例如谷歌搜索建议)的排序,
推荐问题涉及根据用户的消费历史和个人资料向其推荐一件或一组物品(例如 Netflix)。
现在你已经复习了分类问题的基本知识,让我们开始吧!
XGBoost 是一款非常流行的机器学习库,这并非偶然。它最初是作为 C++ 命令行应用程序开发的。在赢得一项知名的机器学习竞赛后,该软件包开始在机器学习社区中得到广泛应用。因此,调用其核心 C++ 代码的绑定或函数开始出现在各种其他语言中,包括 Python、R、Scala 和 Julia。本课程将重点介绍 Python API。
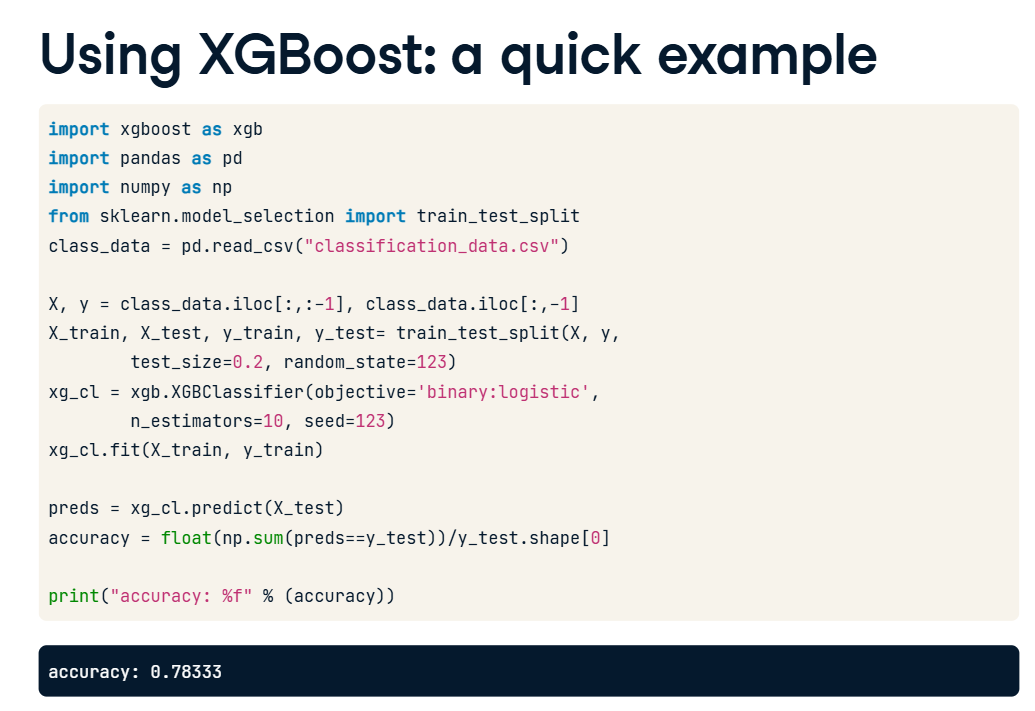
XGBoost 为何如此受欢迎?答案是它的速度和性能。由于 XGBoost 的核心算法是可并行化的,因此它可以充分利用现代多核计算机的强大处理能力。此外,它还可以并行化到 GPU 以及计算机网络中,从而能够训练包含数亿个训练样本的超大型数据集上的模型。然而,XGBoost 的速度并非其真正的优势所在。毕竟,速度快但性能差的机器学习算法最终难以在社区中得到广泛应用。XGBoost 之所以如此受欢迎,是因为它在机器学习竞赛中始终优于几乎所有其他单一算法方法,并且在各种基准机器学习数据集上都展现出了最先进的性能。以下示例展示了如何使用 XGBoost 解决分类问题。
在第 1-4 行,我们导入了将要使用的库或函数,包括 xgboost 和 scikit-learn 中的 train/test/split 函数。请记住,构建机器学习模型时,始终需要使用训练/测试集划分数据,其中一部分数据用于训练,其余部分用于测试,以确保模型不会过拟合,并且能够泛化到未见过的数据。在第 5 和 6 行,我们从文件中加载数据,并将整个数据集拆分为一个按特征排列的样本矩阵(按惯例称为 X)和一个目标值向量(按惯例称为 y)。在第 7 行,我们创建训练/测试集划分,保留 20% 的数据用于测试。在第 8 行,我们使用一些参数实例化 xgboost 分类器,这些参数我们稍后会介绍。第 9 和 10 行应该对您来说很熟悉。XGBoost 具有与 scikit-learn 兼容的 API,这就是它!它采用了之前应该已经见过的拟合/预测模式,即先在训练集上拟合(或训练)我们的算法,然后通过使用测试集生成预测结果,并将预测结果与测试集上的实际目标标签进行比较来评估算法。第 11 行和第 12 行评估训练模型在测试集上的准确率,并将结果打印到屏幕上。
决策树与 CART
因为 XGBoost 通常与决策树作为基础学习器一起使用,所以我们需要了解什么是决策树,以及它是如何工作的。
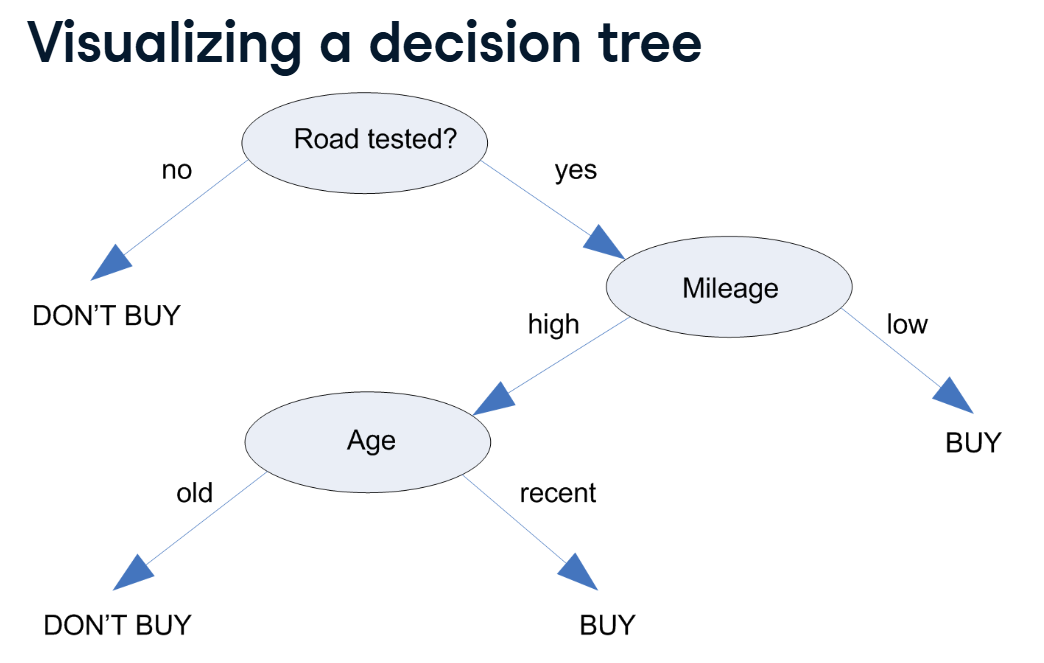
这是一个决策树示例。如您所见,每个决策节点都只提出一个问题,并且只有两个可能的选择。在每个决策树的最底部,只有一个最终的决策。在这个关于是否购买车辆的决策树示例中,您首先要问的问题是这辆车是否经过路试。如果没有,您立即决定不购买;否则,您会继续询问其他问题,例如车辆的里程数以及车龄是较新还是较旧。最终,每个可能的决策都会导向一个选择,只是有些选择所需的问题数量比其他选择少得多。
决策树的构建是迭代进行的(即每次只进行一个二元决策),直到满足某个停止准则(例如,树的深度达到预定义的最大值)。在构建过程中,树是逐个分割的,分割的选择方式(即选择哪个特征进行分割以及在特征值范围内的哪个位置进行分割)可能有所不同,但其核心在于选择一个能够更好地分离目标值的分割点(将每个目标类别放入越来越倾向于单一类别的桶中),直到给定分割点内的所有(或几乎所有)值都完全属于某个类别。通过这种方式,决策树的每个叶节点都将具有占多数的单一类别,或者应该完全属于某个类别。
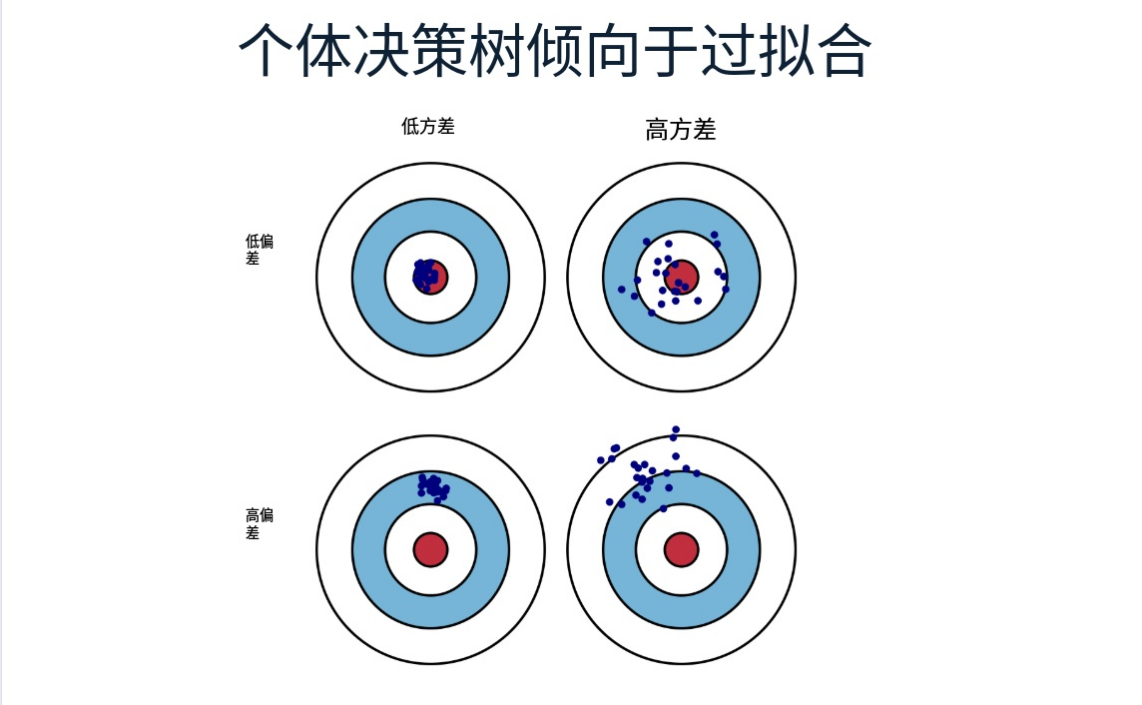
总体而言,单个决策树是低偏差、高方差的学习模型。
也就是说,它们非常擅长学习训练数据中的关系,但它们往往会过度拟合训练数据,并且通常难以泛化到新数据。XGBoost 使用的是一种略有不同的决策树。
这种树被称为分类回归树(CART)。与上述决策树的叶节点始终包含决策值不同,CART 树的每个叶节点都包含一个实值分数,无论其用于分类还是回归。如有必要,可以对这些实值分数进行阈值处理,以将其转换为分类问题的类别。
提升算法的核心思想
现在我们已经回顾了监督学习和决策树的基础知识,接下来让我们谈谈赋予 XGBoost 最先进性能的核心概念——提升。
从本质上讲,提升算法并非一种具体的机器学习算法,而是一种可以应用于一组机器学习模型的概念。因此,它实际上是一种元算法。具体来说,它是一种集成元算法,主要用于降低单个学习器的方差,并将多个弱学习器转化为一个任意强的学习器。
弱学习器是指性能仅略优于随机猜测的机器学习算法。例如,如果一个决策树预测某个结果的频率略高于纯随机预测,那么它就被视为弱学习器。XGBoost 的核心思想在于,它可以通过提升算法将一组弱学习器转化为强学习器。强学习器是指任何可以通过调优来针对特定监督学习问题达到任意优异性能的算法。
这是如何实现的呢?通过迭代地在现有数据子集上学习一组弱模型,并根据每个弱模型的性能对它们的预测结果进行加权。然后,将所有弱模型的预测结果乘以其权重,得到一个最终的加权预测结果,该结果远优于任何单个预测结果。这种方法的效果如此之好,着实令人惊叹。
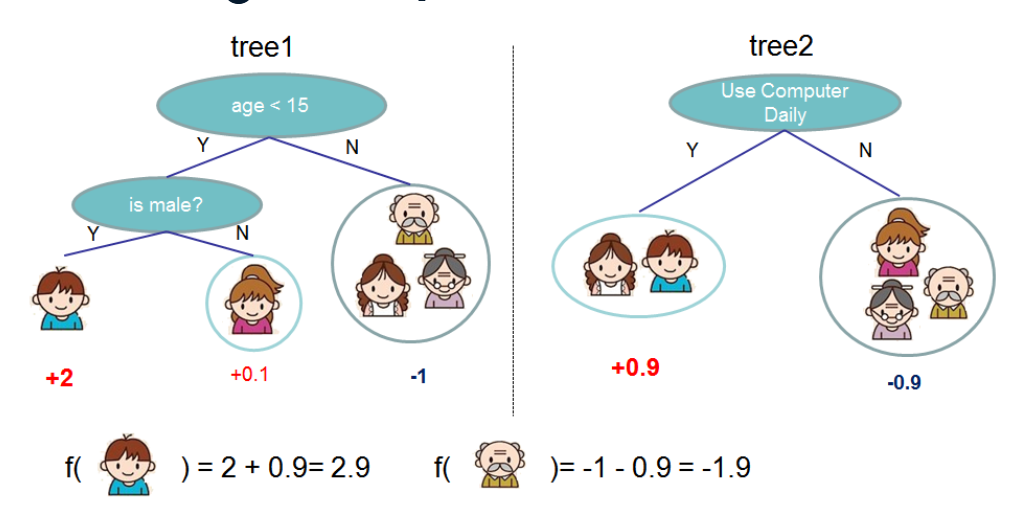
这里有一个使用两棵决策树进行提升算法的简单示例。这个例子来自 XGBoost 的文档,它展示了对于给定的特定样本,每棵树会根据其所看到的数据给出不同的预测分数。每种可能性的预测分数在两棵树上相加,最终的预测结果就是两棵树预测分数的总和。在这里,你可以看到,无论我们试图预测什么,小男孩在两棵树上的预测分数总和都高于老人。
交叉验证与模型评估
接下来我们将使用 XGBoost 的学习 API 进行模型评估,因此最好先简要介绍一下如何使用 XGBoost 的学习 API(与 scikit-learn 兼容的 API 不同)进行交叉验证模型评估,因为 XGBoost 的学习 API 内置了交叉验证功能。简单来说,交叉验证是一种稳健的方法,它通过在训练数据上生成多个互不重叠的训练/测试集划分,并计算所有划分的平均测试集性能,来估计机器学习模型在未见过的数据上的预期性能。
五折交叉验证就是将数据均匀分成五份,其中四份训练集, 一份作为测试集,训练五次取最好。
何时使用 XGBoost
综上所述,关于 XGBoost,何时应该(以及何时不应该)使用它?
鉴于我已经简单介绍过 XGBoost 的优势所在,以下内容应该不会让您感到意外。对于符合以下条件的任何监督式机器学习任务,您都可以考虑使用 XGBoost:您拥有大量的训练样本。虽然“大量”的定义可能因人而异,但我这里指的是特征数量较少但至少包含 1000 个样本的数据集。不过,一般来说,只要训练集中的特征数量小于样本数量,就应该没问题。最后,当数据集包含类别型和数值型特征,或者仅包含数值型特征时,XGBoost 的表现通常都不错。
什么情况下不应该使用 XGBoost?XGBoost 并非最佳选择的最主要情况包括:一些问题已经通过其他先进算法取得了成功,或者存在数据集规模不足的问题。具体来说,XGBoost 并不适合图像识别、计算机视觉或自然语言处理和理解等问题,因为这些问题使用深度学习方法可以更好地解决。就数据集规模而言,当训练集非常小(少于 100 个训练样本)或训练样本数量远小于用于训练的特征数量时,XGBoost 就不适用。