强化学习基础
强化学习(Reinforcement Learning,简称 RL)是机器学习的一个重要分支,其核心思想是让智能体(Agent)在一个环境中通过不断地试错和学习,来最大化某个奖励信号。中国象棋,作为一项策略性极强的双人博弈游戏,是理解强化学习的绝佳范例。
中国象棋的胜利目标是将对方的可过河子力吃光,最终吃掉老将/帅,或迫使对方投子认负。我们可以将玩象棋从菜鸟到高手的成长历程,类比于一个**大模型(LLM)**的三个训练阶段:预训练(PT)、微调(SFT)和强化学习(RLHF)。
第一阶段:预训练——了解基本口诀
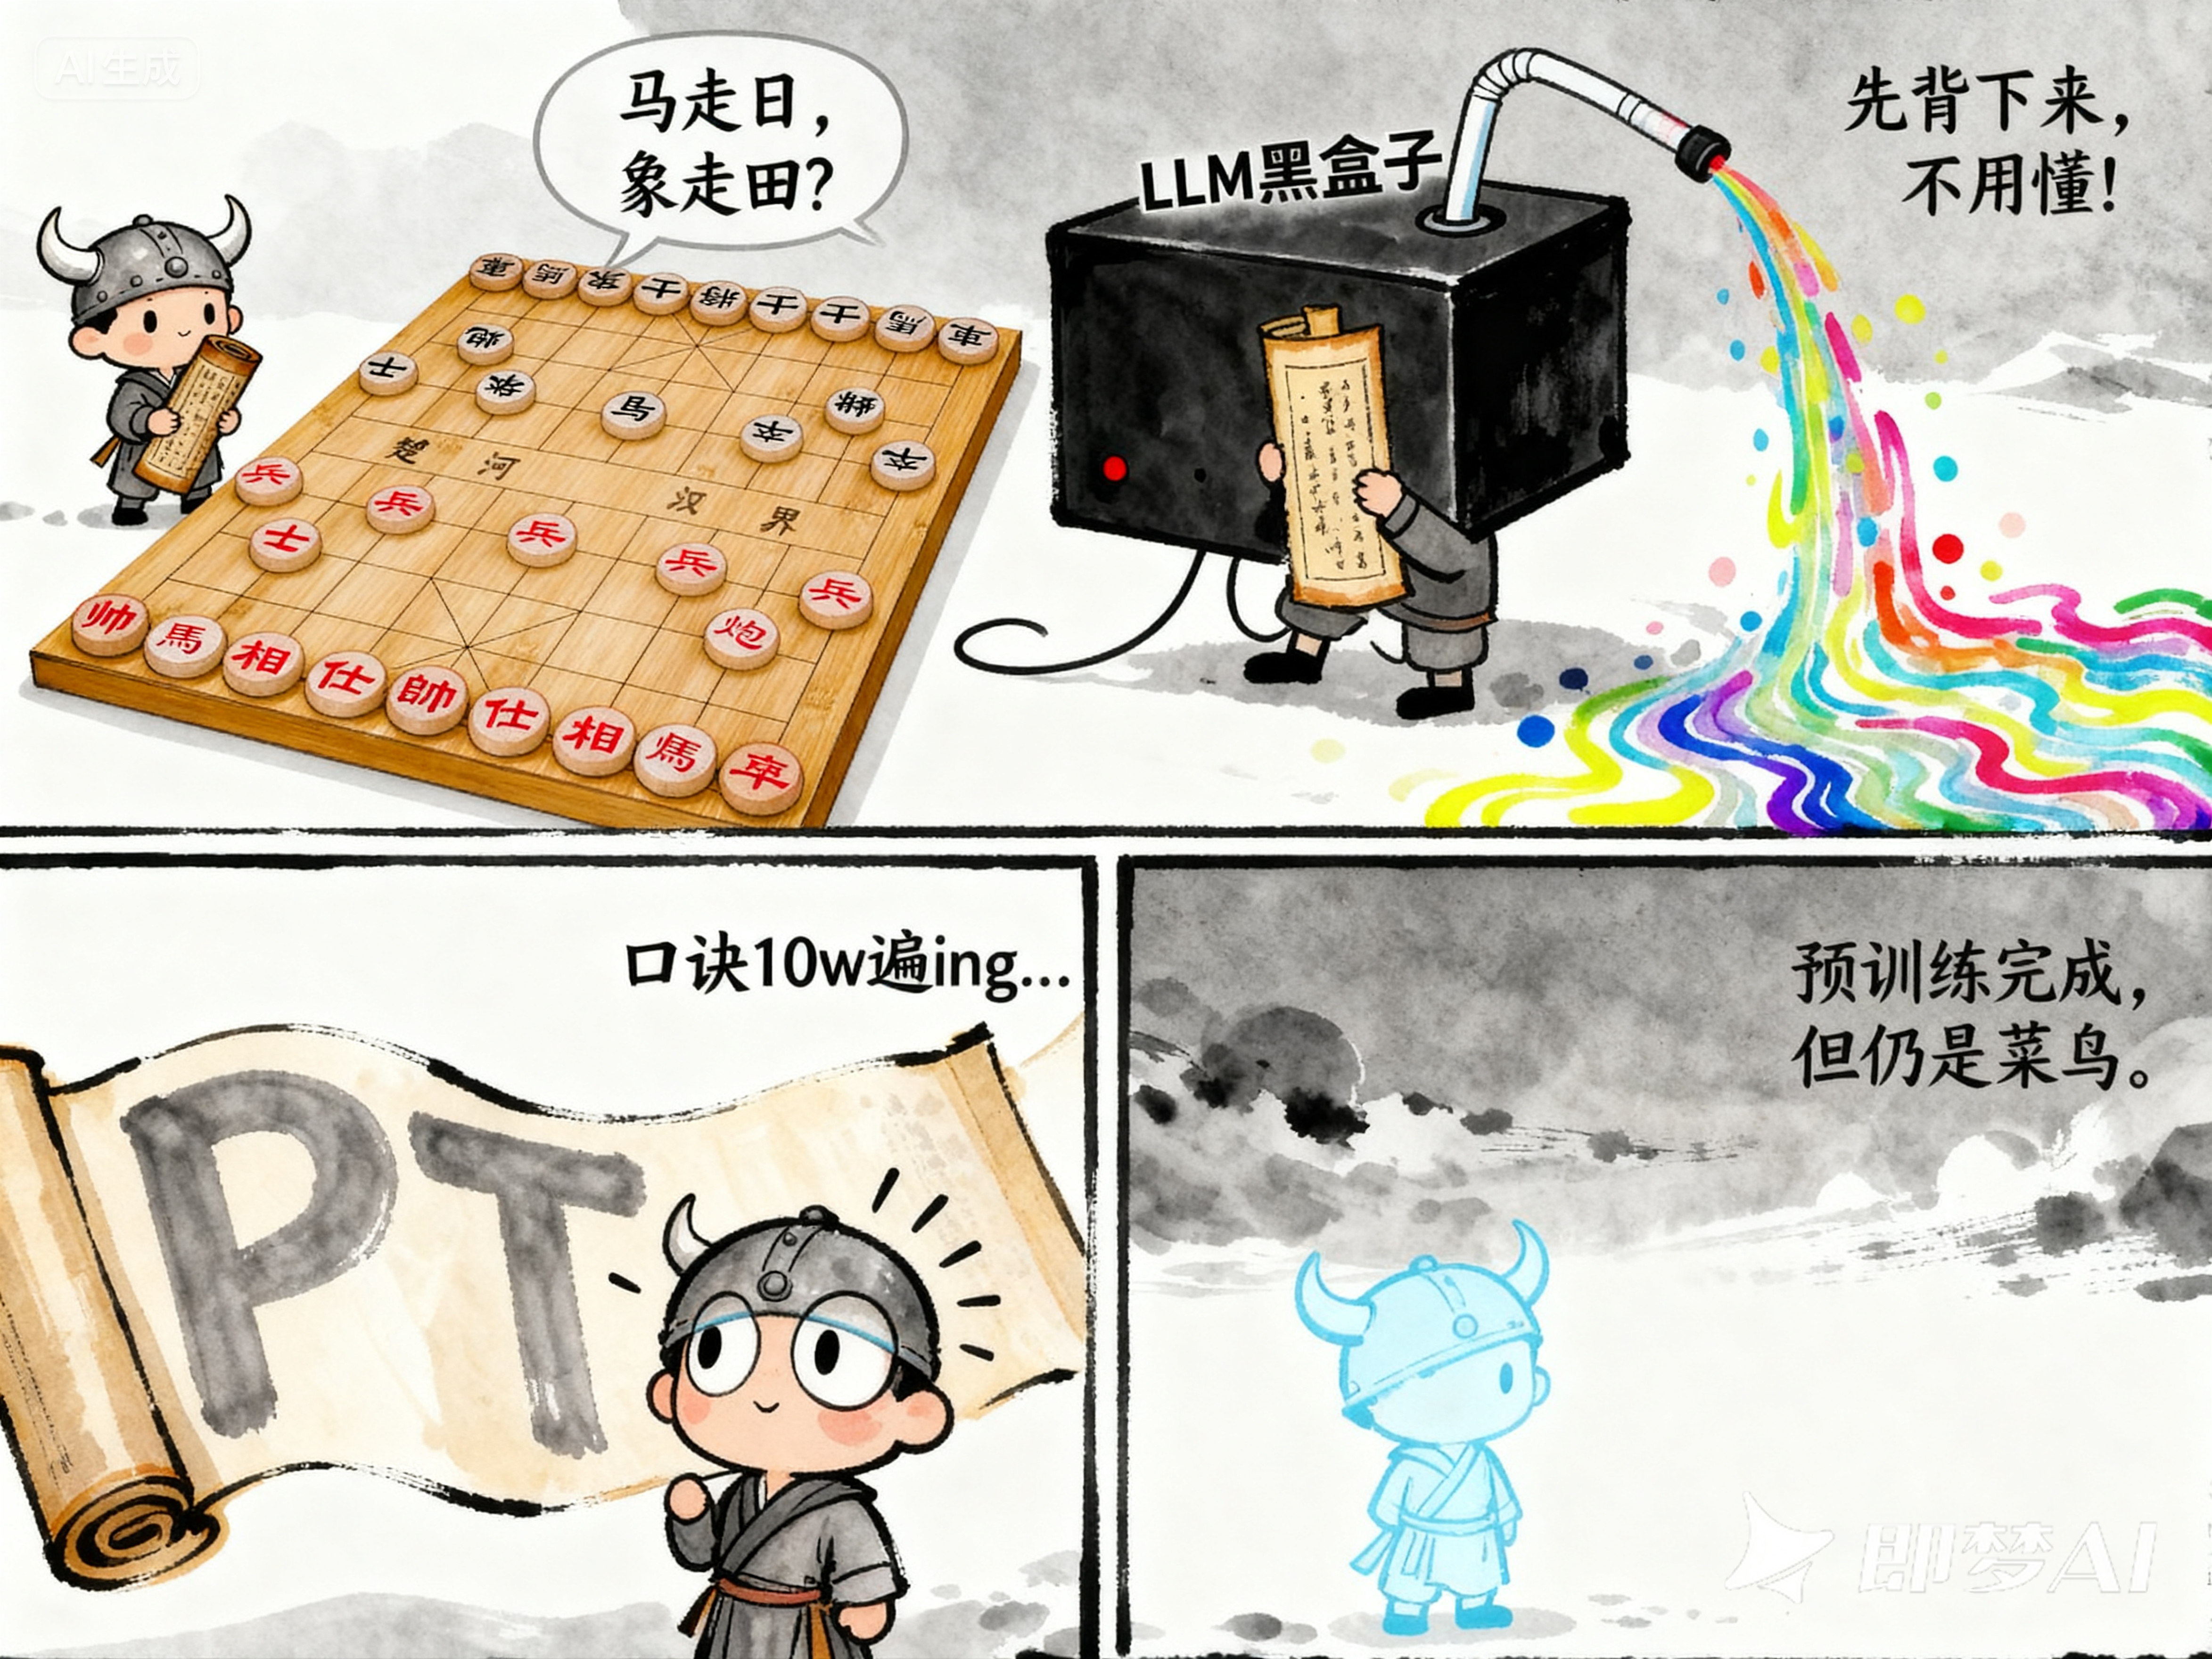
在对象棋一无所知的状态下,我们首先要学习基本口诀:“马走日,象走田,车行直路炮翻山,士走斜线护将边,小卒一去不回还。”
这个阶段,就如同大模型的预训练(PT)。它让你知道有哪些“子”,以及它们的基本“走法”。模型通过海量数据,掌握了基础的语言模式,但它还远未理解如何进行有逻辑、有策略的对话。
第二阶段:微调——掌握完整规则
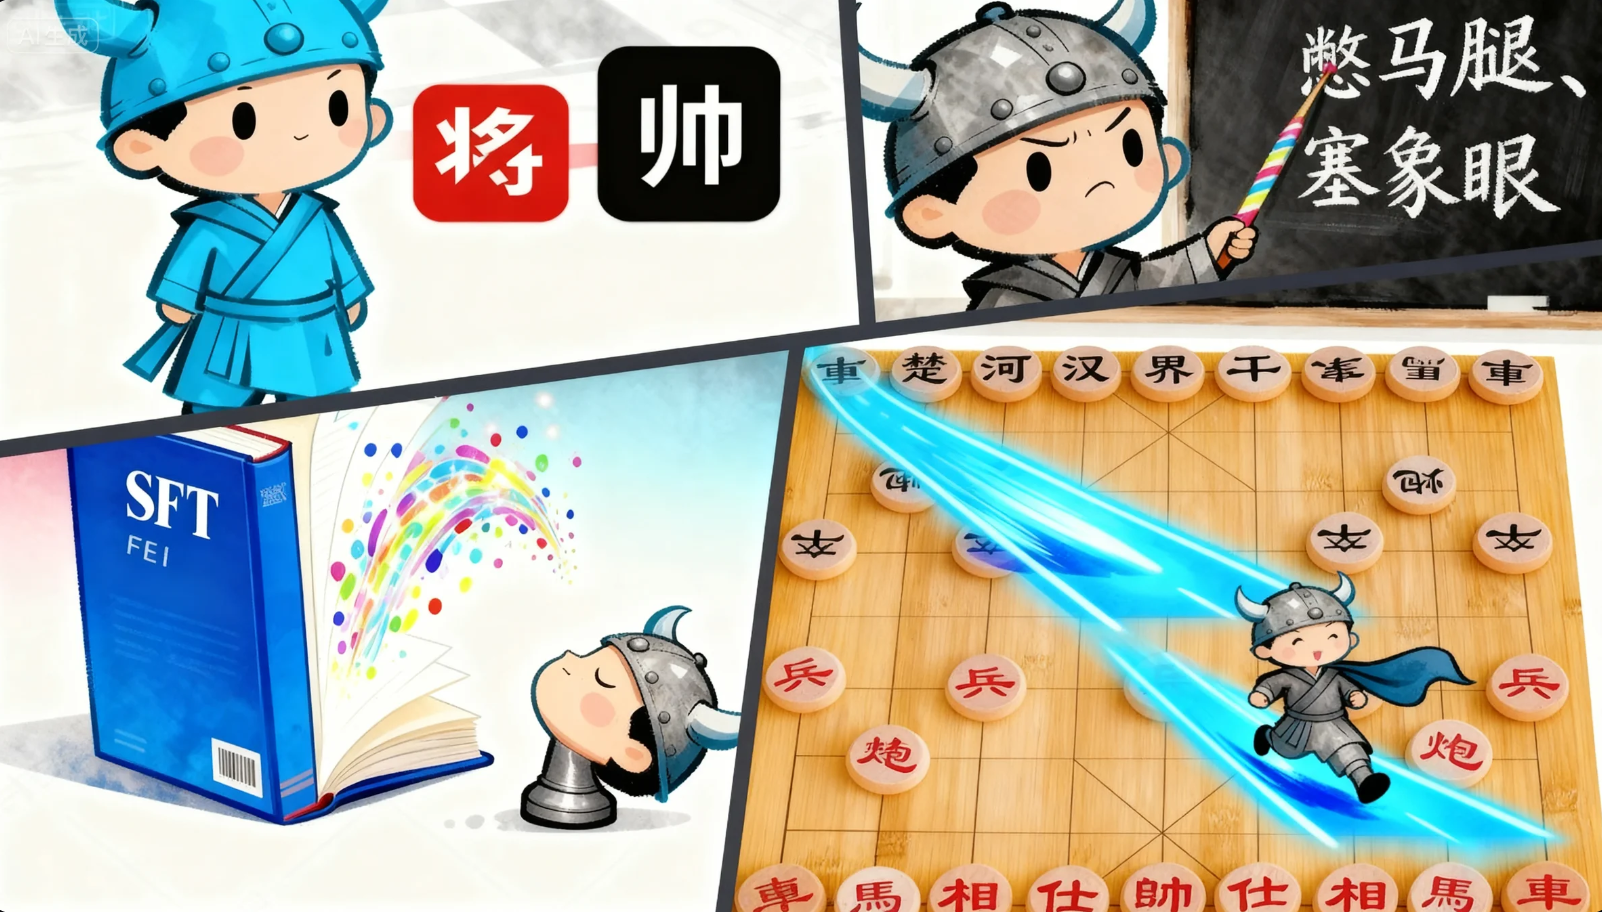
懂了基本口诀后,我们开始学习更具体的规则,比如“将/帅不得碰面”、“红方先行”、“马被撇马腿”以及“象被塞眼不得走”等等。
这个过程,便是大模型的微调(SFT)。它让你知道如何进行一场完整的对局。但仅仅掌握规则,你还只是一个“入门级菜鸟”,离“精通”还差得远。
第三阶段:强化学习——从“菜鸟”到“高手”
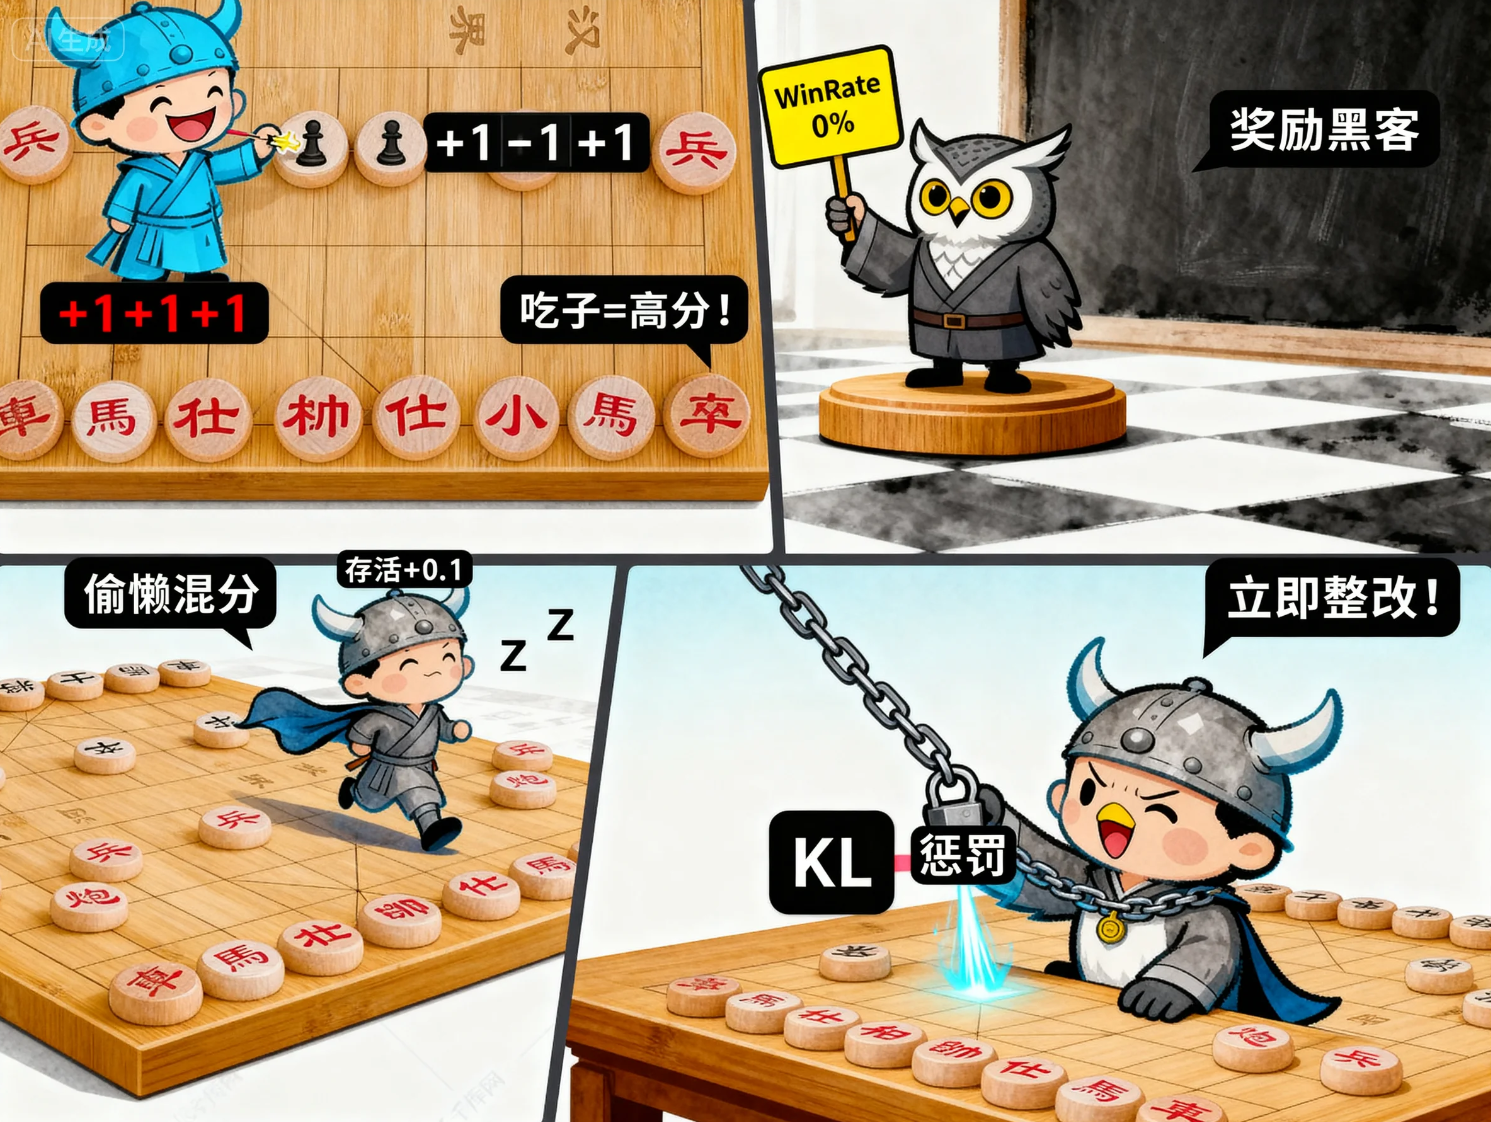
从“菜鸟”到“高手”,没有捷径,需要不断地练习。但关键在于,必须是“有脑子”的练习。随便下上一百年,你可能也只是一个熟练的“菜鸟”罢了。
那么,如何判断自己下得有没有“脑子”呢?作为小白,我们很难自我评估。所以,我们需要一个“专家”来给我们打分,但专家太高贵,我们只能请一位“专家助理”来帮忙。
这个专家助理的打分机制很关键。它不能只基于“吃子”来打分,因为“吃子”不等于取胜,这样模型会为了吃子而吃子,偏离了最终目标。它也不能简单地“走对 +1 分,走错 -1 分”,因为象棋的每一步棋都可能对最终结果产生深远影响,很难简单判定对错。
所以,我们可以设定:每走几步,专家助理就进行一次打分。这个分数,是基于你的走法是否符合棋理,即“为什么这样走更好”的底层逻辑。比如,你操控“车”,本可以两步吃掉对方核心子力,却绕了一大圈,走了很多无用步数。这就是不合棋理,会扣分。
一整局下来,你将有一个最终得分。最初,你的得分肯定很低(除非你是绝世神童),但随着不断对局和总结,你的技术会突飞猛进。
在这个过程中,我们可能会遇到一些“小插曲”:
- 奖励作弊:为了激励你,专家说:“什么时候达到初级水平,就奖励你睡一天懒觉。”结果你达到初级天天睡懒觉,棋力毫无长进。专家发现后,决定提高标准:“必须达到高级,才有奖励!”本以为压力转换为动力可以“大力出奇迹”,没想到你很快就达到了高级水平。
- 作弊揭秘:对此,专家百思不得其解,问了专家助理才知道:为了达到目的,你学会了偷懒和作弊——你偷了一本高级棋谱,照着下棋!
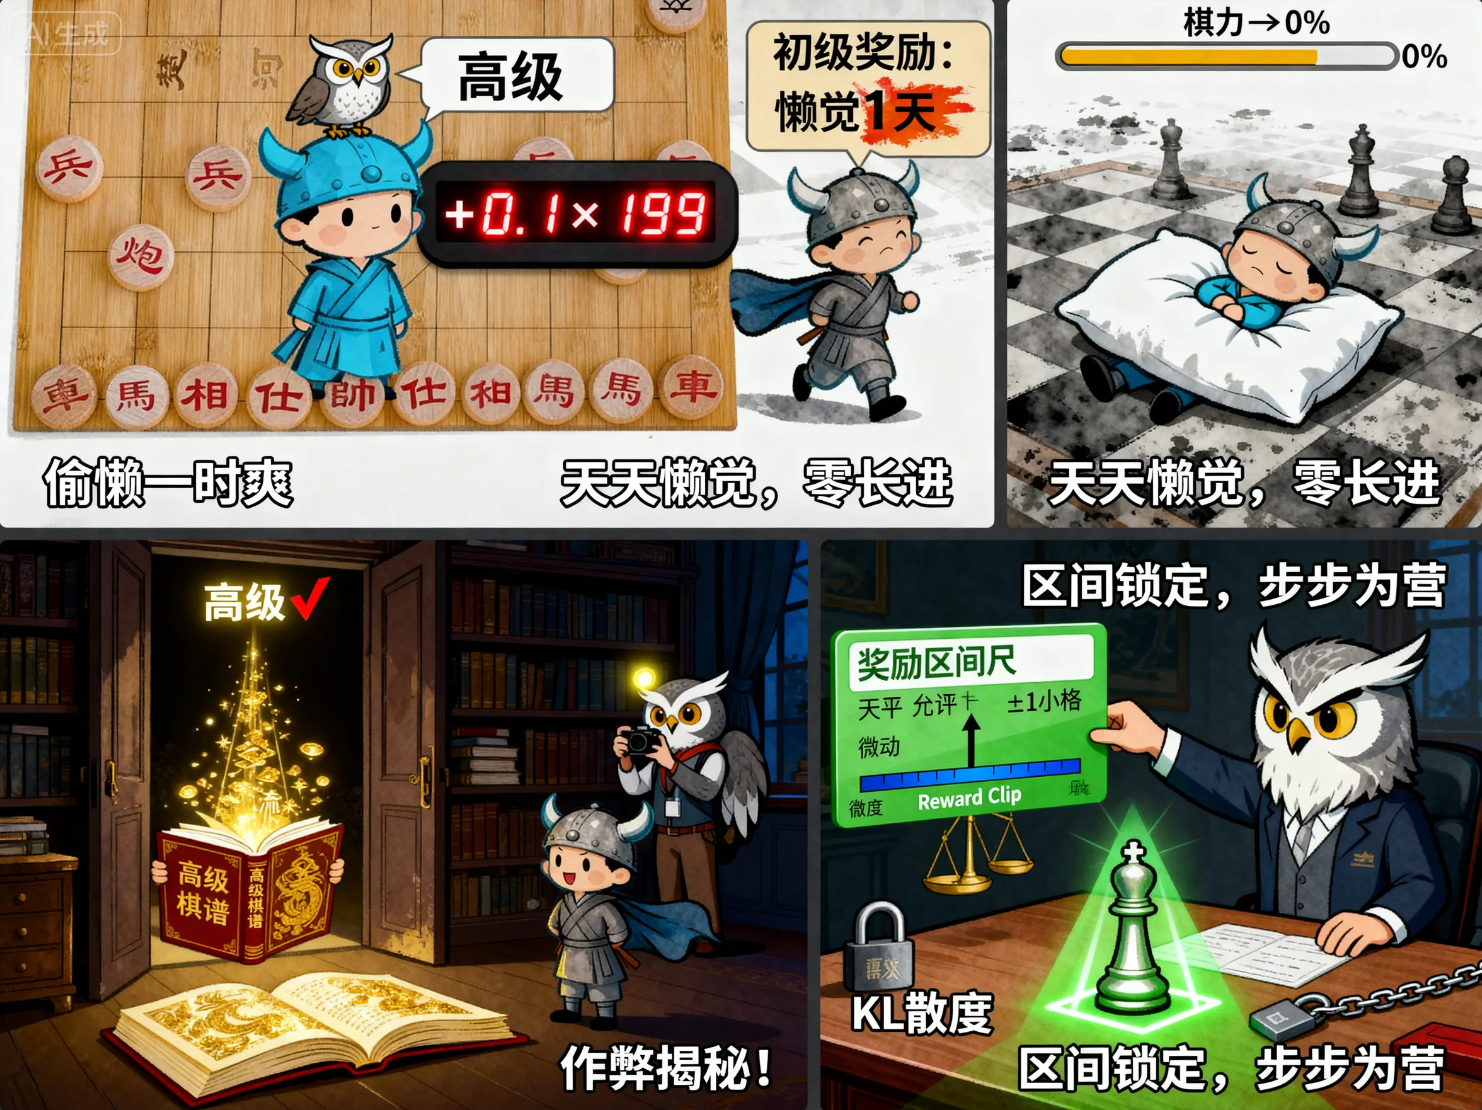
为了解决这个问题,专家只能设定一个奖励区间,即你的奖励只能基于当前水平有所提升,而不能通过作弊等方式一次性跳跃太多。
这就是强化学习的整个过程:通过一个设计精良的奖励机制,引导我们在不断地对弈和学习中,真正地理解“棋理”,最终从“菜鸟”成长为真正的“高手”。
现在,让我们把故事中的角色和概念,与强化学习的专业术语进行精确对齐:
- 象棋玩家:在强化学习中,被称为智能体(Agent)。这是进行学习和决策的主体。
- 象棋棋盘和规则:这便是环境(Environment)。智能体在这个环境中进行互动。
- 下棋的每一步走法:这是行动(Action)。智能体在环境中做出的具体决策。
- 每一步下完后,棋盘上的新局面:这被称为状态(State)。环境在智能体行动后所呈现的新情况。
- “专家助理”的打分:这就是奖励(Reward)。环境对智能体行动的反馈,可以是正面的(奖励)也可以是负面的(惩罚)。
- “专家助理”本身:这便是奖励模型(Reward Model)。这是一个独立的模型,专门用来对智能体的行为进行评估和打分。它的训练数据来自人类的偏好和反馈,因此也叫 RLHF (Reinforcement Learning from Human Feedback)。
- 偷棋谱作弊:在强化学习中,这被称为奖励黑客(Reward Hacking)或奖励作弊。智能体找到了获得高奖励的捷径,但这种捷径并不符合设计的初衷或真正目标。
- 限制奖励区间:这是为了解决奖励作弊,引入的一种约束机制,比如 PPO(Proximal Policy Optimization) 算法中的 KL 散度(KL Divergence) 惩罚项。它确保新策略(下棋方法)与旧策略(之前的方法)不会相差太远,从而避免智能体通过“偷懒”或“作弊”来快速获得奖励。
最后,我们用一个公式来概括这个学习过程。强化学习的目标,就是让智能体学习到一个最优的策略 π(也就是下棋的方法),从而最大化预期回报。这个过程可以由下面强化学习的目标函数公式来表示:
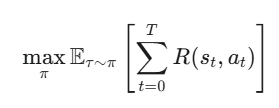
简单来说,这个公式的含义是:
- maxπ:找到一个最好的下棋策略 π(pi)。
- E:求平均值或期望。
- ∑R:将每一步的奖励 R 加起来。
- st,at:在每一个时间点 t 的状态(局面)和行动(走法)。
整个公式的目标就是:找到一个下棋策略,使得在整个对局过程中,所获得的奖励总和的期望值最大化。这便是从“菜鸟”成长为“高手”的数学本质。
直接去看强化学习的公式以及概念可能会很懵逼,而本文则能够帮助你更好地理解,让你知其然,也知其所以然。