标准化、归一化、有量纲无量纲
什么是 有/无 量纲?
量纲是一个类别,并不是一个具体的单位,它是具有宽泛性的,可以表述为时间,而时、分、秒为具体的单位数值。
有量纲就是有单位,比如时间(s),距离(m),速度(v=m/s)
这种可测量的,大小和单位有关的就叫做有量纲,这些是可比较的
而无量纲是什么?
无量纲就是只有数值大小,没有具体单位的值。
通常有比例,系数,概率等……
让不同量纲的数据可以放在同一标准下比较,是数据处理中使用标准化/归一化常见的目标之一。
什么是标准化?
让数据的分布变得标准(平均值 0、波动大小一致),即均值 0,方差 1,范围在(-∞, +∞)。
方差为 1 啥意思?
数据的典型波动范围是 1 个单位。大多数数据会分布在平均值 ±1 附近,这就符合正态分布。(正态分布就是大部分数据都集中在平均值附近,越远就越少的分布)。
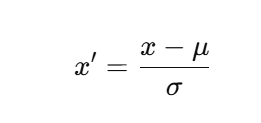
x’= 标准化后的数据
μ = 平均值
σ = 标准差
假设数据为[1,3,5,7,9],计算它们的平均值(μ)
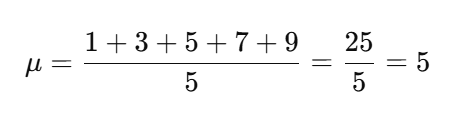
然后计算方差,即每个数据与均值的方差,(x - μ),再平方
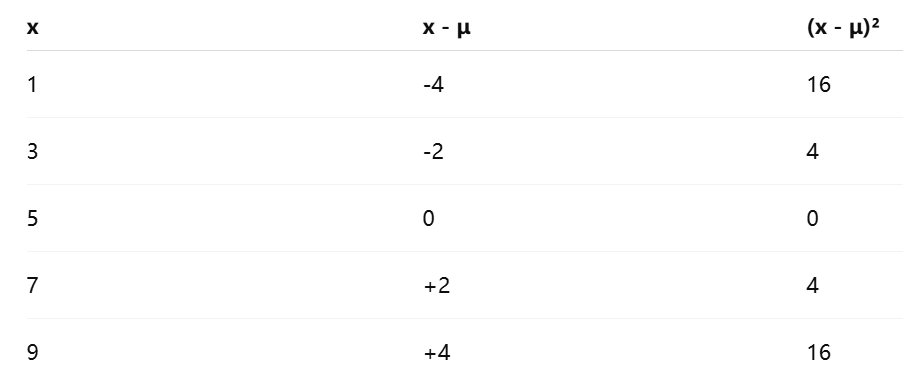
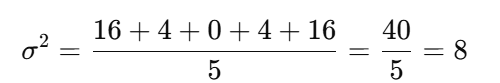
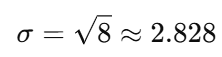
然后再把计算好的值套用公式即可算出最终标准化后的值,
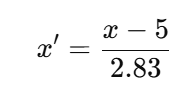
这样就算出来最终结果:
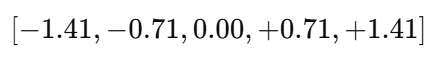
可以看到,标准差 σ 是由数据本身计算出来的,不是自己设的。
同时中间值为 0,这就是中心化(centering),所有数据都围绕 0 来平移,方便我们观察数据分布。
什么是归一化?
把数据拉伸到一个固定区间,一般是[0,1]或[-1,1]之间,这是为了避免数据中某些特征值过大或过小计算后导致结果偏差,但是因为这个计算方式依赖最大值和最小值,如果数据有比较大的异常值(极值)可能会影响最终计算结果。
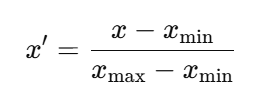
比如给出一组身高[160,170,180,190](cm)
这样的数据比较平滑,计算结果也会分布均匀,而如果突然有一个身高 3m 的,这样计算后就会显著拉高整体分布,明显因为极值的出现对结果产生了偏移。
标准化和归一化的区别?
标准化就是让数据变的标准,符合正态分布(均值为 0、方差为 1)。
归一化就是缩放,让数据都等比例进行缩放,缩放到一个区间方便查看分布
标准化 和 归一化 最本质的区别之一,就在于对异常值(outliers)的敏感程度不同,
标准化是基于均值和方差,对单独的极值影响较小,即使一组数据中出现了一个非常大的值,也仅是这一个值标准化后的结果会比别的值拉大几个波动单位,而其他值仍然分布变化比较平滑,不会彻底改变其他点的相对关系。
而归一化不同,因为归一化是基于最大值与最小值进行计算的,所以极值会导致整体数据分布偏移,所有点的关系都会因为极值过大导致每个点之间有较大偏差,在神经网络训练模型时可能会导致模型无法学习到数据间正常规律,被这种噪声所影响,所以可基于使用场景的不同结合标准化和归一化或只采用标准话进行处理。
什么时候用?
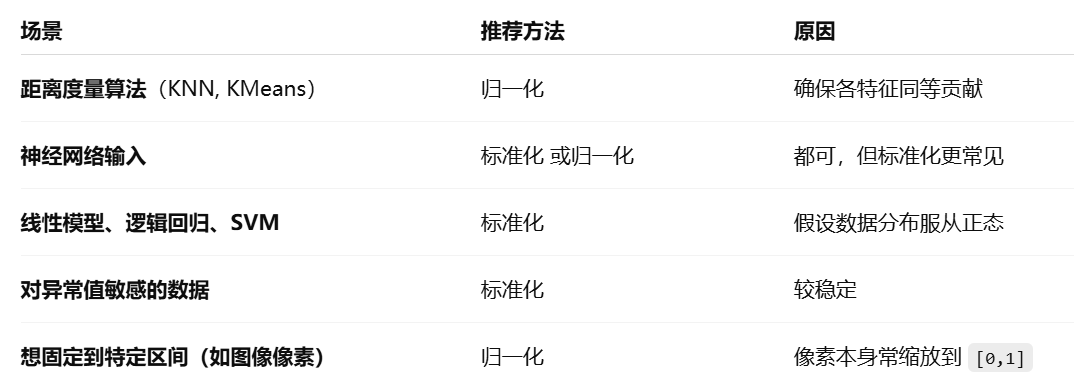
使用方式并不绝对,要看具体场景任务,也可按需结合使用。